一个月,106 亿 token
月初我干了件闲事:把 6 月份 Claude Code 的使用记录拉出来跑了个统计。
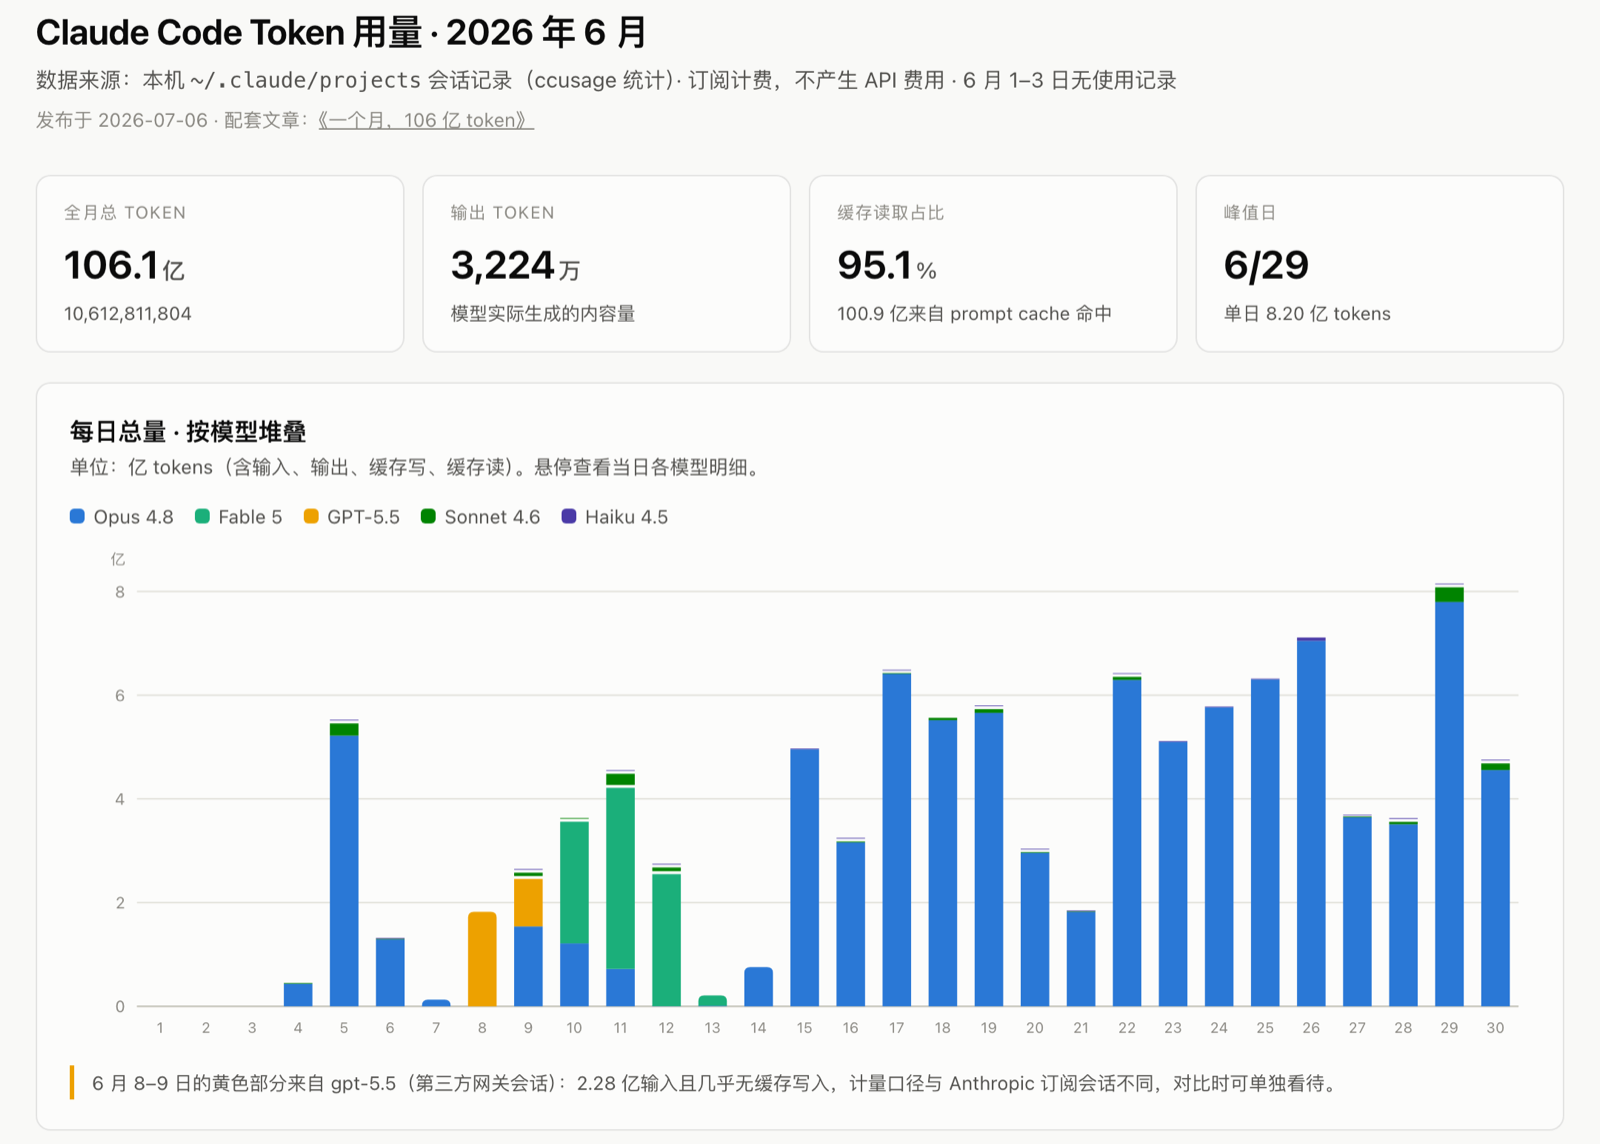
跳出来一个数:10,612,811,804。
106 亿 token。一个人,一台 Mac,一个命令行,一个月。
一本《红楼梦》大约一百万 token。也就是说,这个 6 月,我和 Claude 之间流过的 token,相当于一万遍《红楼梦》。
先别急着惊叹。因为这个数字,95% 是「注水」的。
106 亿里,100.9 亿是它在「重读」
Claude Code 的工作方式是这样的:你说一句,它就要把整个对话从头到尾重新看一遍,再决定下一步干什么。对话越长,每一轮要重看的东西越多。
要是每一轮都老老实实按新内容计费,谁也用不起。所以有 prompt cache:读过一遍的上下文缓存起来,下一轮命中缓存,速度快、成本低,占订阅额度的权重也远低于新输入。
拆开 106 亿,账是这样的:
- 缓存读取:100.9 亿,占 95.1%——它在一遍遍重读我们已经聊过的话
- 缓存写入:2.3 亿——第一次读到的新上下文,存起来备用
- 新输入:2.6 亿——其中 2.3 亿还是月初一次第三方网关实验的口径差异,刨掉之后,我真正敲给它的新东西不到 3,000 万
- 输出:3,224 万——它真正生成的内容
所以「106 亿」听着吓人,真相是:大头是机器在反复温习,不是我有多能聊。
真正的干货:3,224 万输出
看 token 账单,输出才是产出。
3,224 万 token 的输出,粗算约等于 2,400 万个英文单词。一部长篇小说按 10 万词算,这是 240 本长篇小说的体量——代码、文档、方案、排错记录,一个月里从一个命令行里流出来。
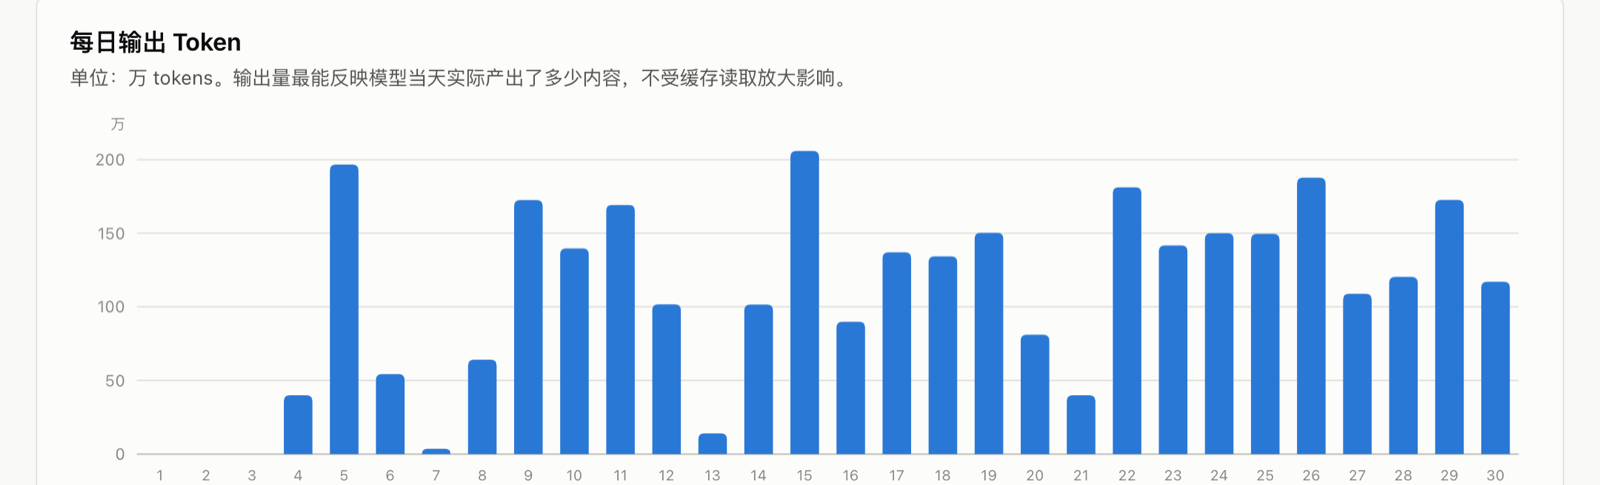
当然不是每个字都能用。但哪怕按很苛刻的折扣打下去,这个产出量也是我一个人手敲一辈子都追不上的。
这份日历会讲故事
把每日用量按模型上色,6 月的日历自己开口了:
- 6 月 1–3 日:空白。 数据不会撒谎,那几天我确实没干活。
- 6 月 8–9 日:一段黄色。 GPT-5.5,走第三方网关做的实验。1.5 亿裸输入、缓存写入为零——没有缓存的世界就是这么贵。两天就撤了。
- 6 月 10–13 日:一大块绿色。 Fable 5,四天 8.81 亿。就是《我把 Fable 5 用到提前下线》里那几天——当时只有截图,现在有数据背书了。
- 之后一路蓝色。 Opus 4.8 稳定主力,几乎天天在线。
- 6 月 29 日:峰值。 单日 8.2 亿,那天几个会话并排跑了一整天。
我写周报都未必有这份日历诚实。
给你的三个看账单姿势
如果你也在用 Claude Code(或任何按 token 计量的工具),账单只需要看三个数:
- 输入——你真正给它的新内容。这个数小,说明你会复用上下文。
- 输出——它真正产出的。这个数才配叫「产量」。
- 缓存读取——它反复重读的量。这个数大不用慌,它便宜,而且恰恰说明你在长对话里干大活。
至于「总量」?那是个虚荣指标。拿总量吓人(或者自我感动),都属于没看懂账单。
106 亿里,95% 是它在一遍遍重读我们已经聊过的话,只有 5% 是新东西。
想想还挺像人的:所谓思考,大部分时候也是在反刍已知。真正的新输入和新表达,从来都是小头——但产出,恰恰就从那 5% 里来。
📊 完整的交互版报告在这里:Claude Code Token 用量 · 2026 年 6 月——每根柱子都能悬停看当日明细,还有全月逐日数据表。数据来自本机会话记录,ccusage 统计,订阅计费,没花一分 API 的钱。