模型挤在同一扇门里,Agent 已经走到了门外
作者:城北
九月第一天的终端窗口格外拥挤。Claude Code 刚弹出新版提示,另一边的 Codex CLI 也更新了;浏览器标签页里,Anthropic 的 Fable 5.1、SpaceXAI 的 Grok 4.6、Google 尚处预览阶段的 Gemini 3.1 Pro,以及 OpenAI 夏天发布的 GPT-5.6,像是约好了在同一个工作台上争夺光标。与此同时,Kimi、GLM、Qwen、DeepSeek 等国产模型也在迅速补位。
这种密集感很容易制造一种错觉:发布季的主角仍然是一张越来越长的跑分表。但真正值得开发者注意的变化发生在表格之外。模型厂商已经不满足于回答问题,而是在争夺终端、IDE、代码仓库和云端执行环境。竞争单位正在从“一个模型”变成“一个可以把任务做完的系统”。
这一轮真正的分水岭,不是谁能在榜单上多赢几分,而是谁能把聪明变成持续、可控、可交付的行动。
发布季里,各家真正交出的牌
Anthropic:把最高能力层单独切出来
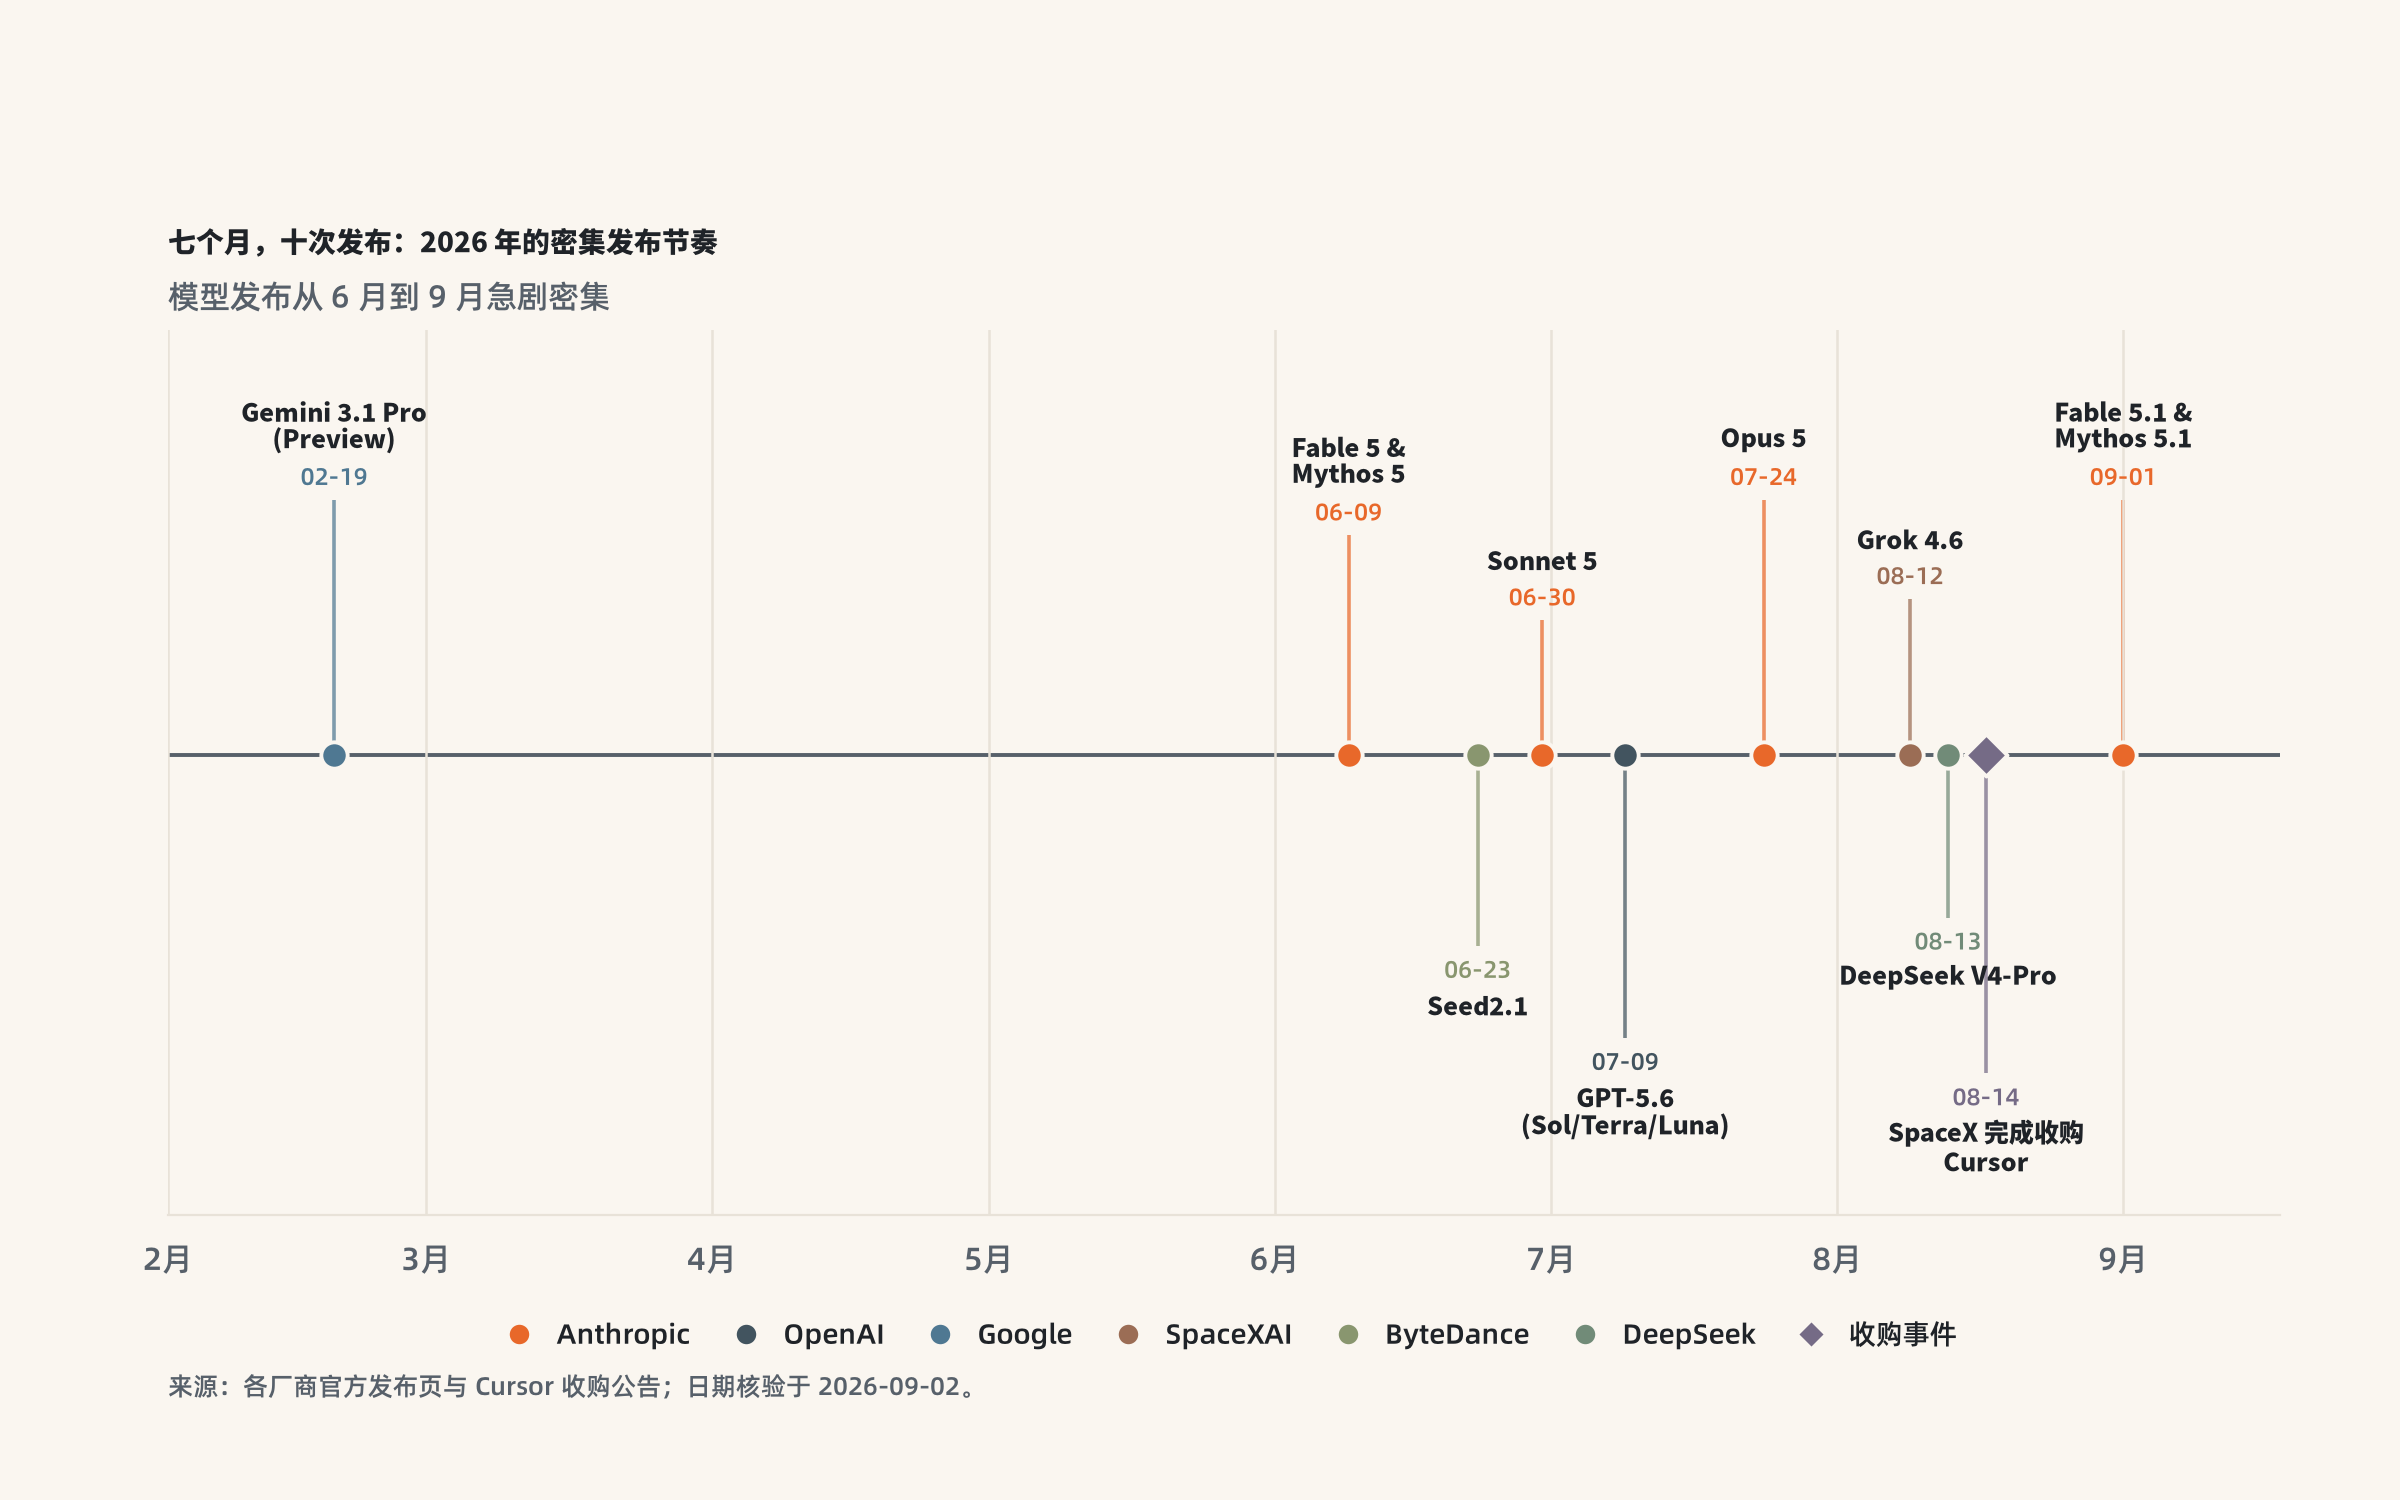
Anthropic 在 2026-09-01 同时发布 Claude Fable 5.1 与 Claude Mythos 5.1。这里先拆掉一个常见误会:它们不是一个含糊的“Claude 5.1”,也不是两套能力完全不同的模型。二者共用同一个底层模型,区别在保障机制与开放范围。Fable 面向所有用户,是编码、知识工作和长时程 Agent 场景的最高能力层;Mythos 只向网络安全与生命科学场景中的可信用户开放。有趣的是,Mythos 的字面意义反而比 Fable 更接近中文里的“神话”,难怪名字常被传混。
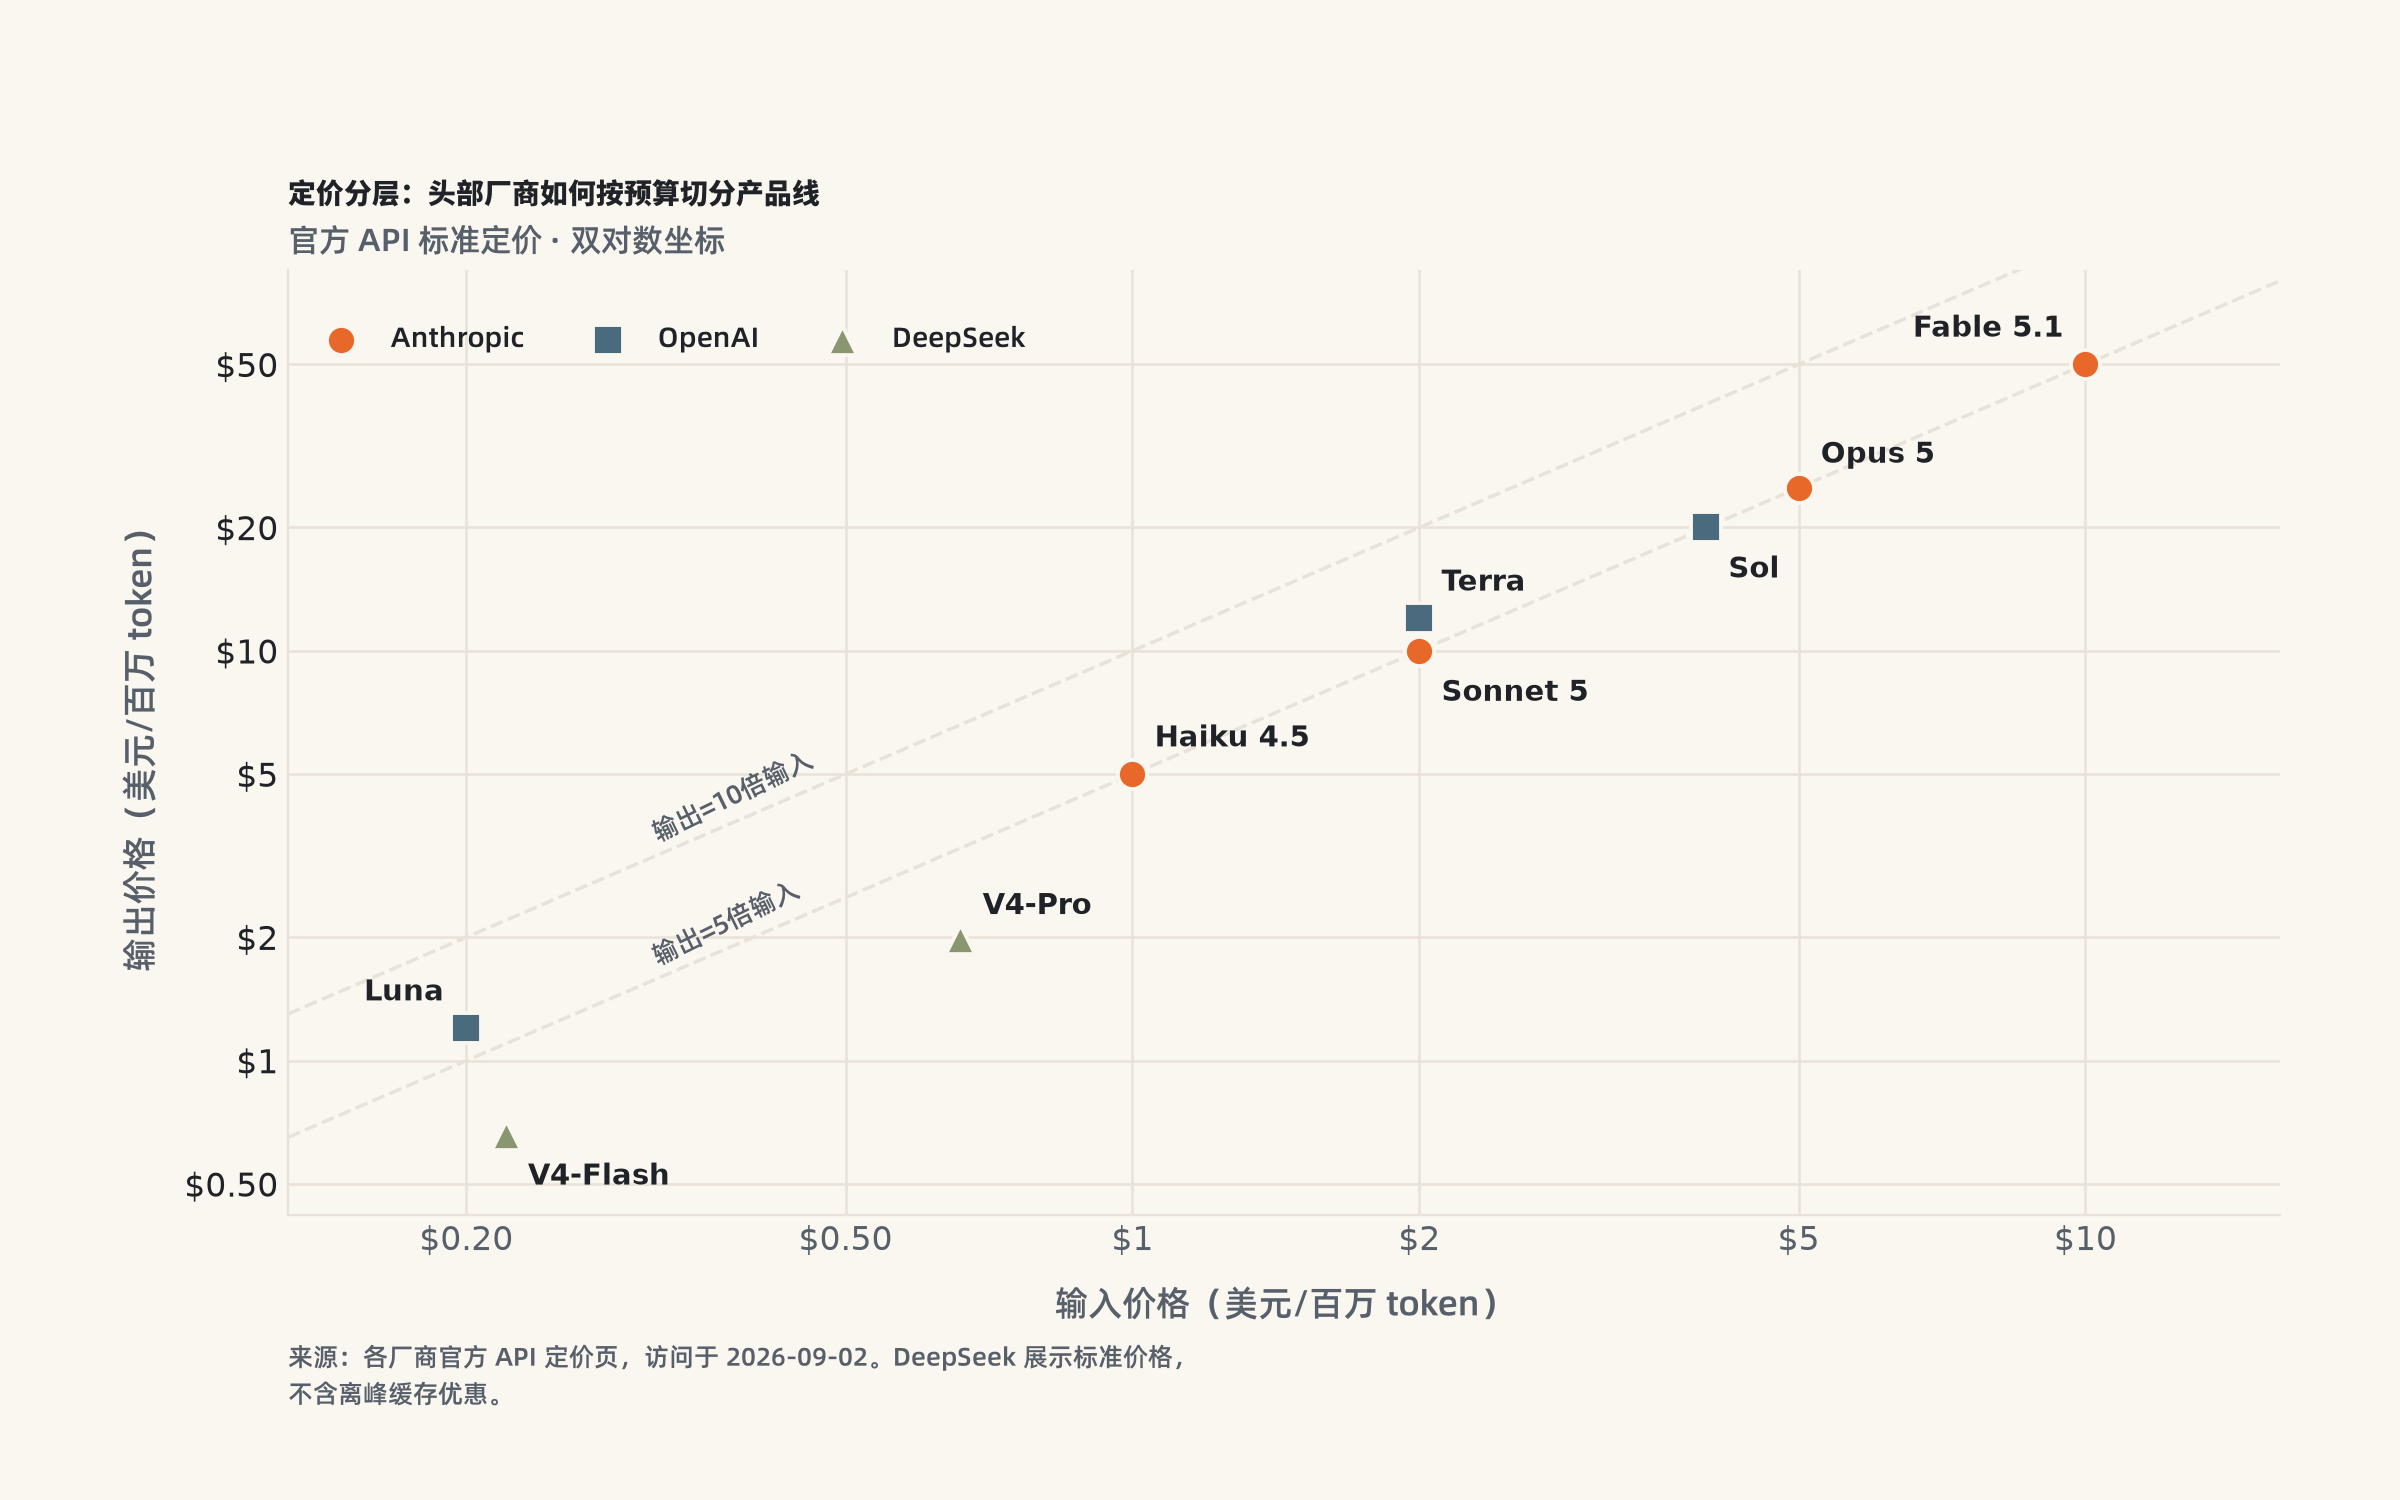
Fable 5.1 的上下文窗口为 1M token,输入、输出和缓存读取价格分别为 $10、$50、$0.25/百万 token。Anthropic 的产品阶梯因此变得很清晰:Haiku 4.5 负责低延迟和子 Agent,Sonnet 5 是规模化 Agent 执行层,Opus 5 承担日常高端任务,Fable 5.1 则站在最高能力与最高价格的一端。
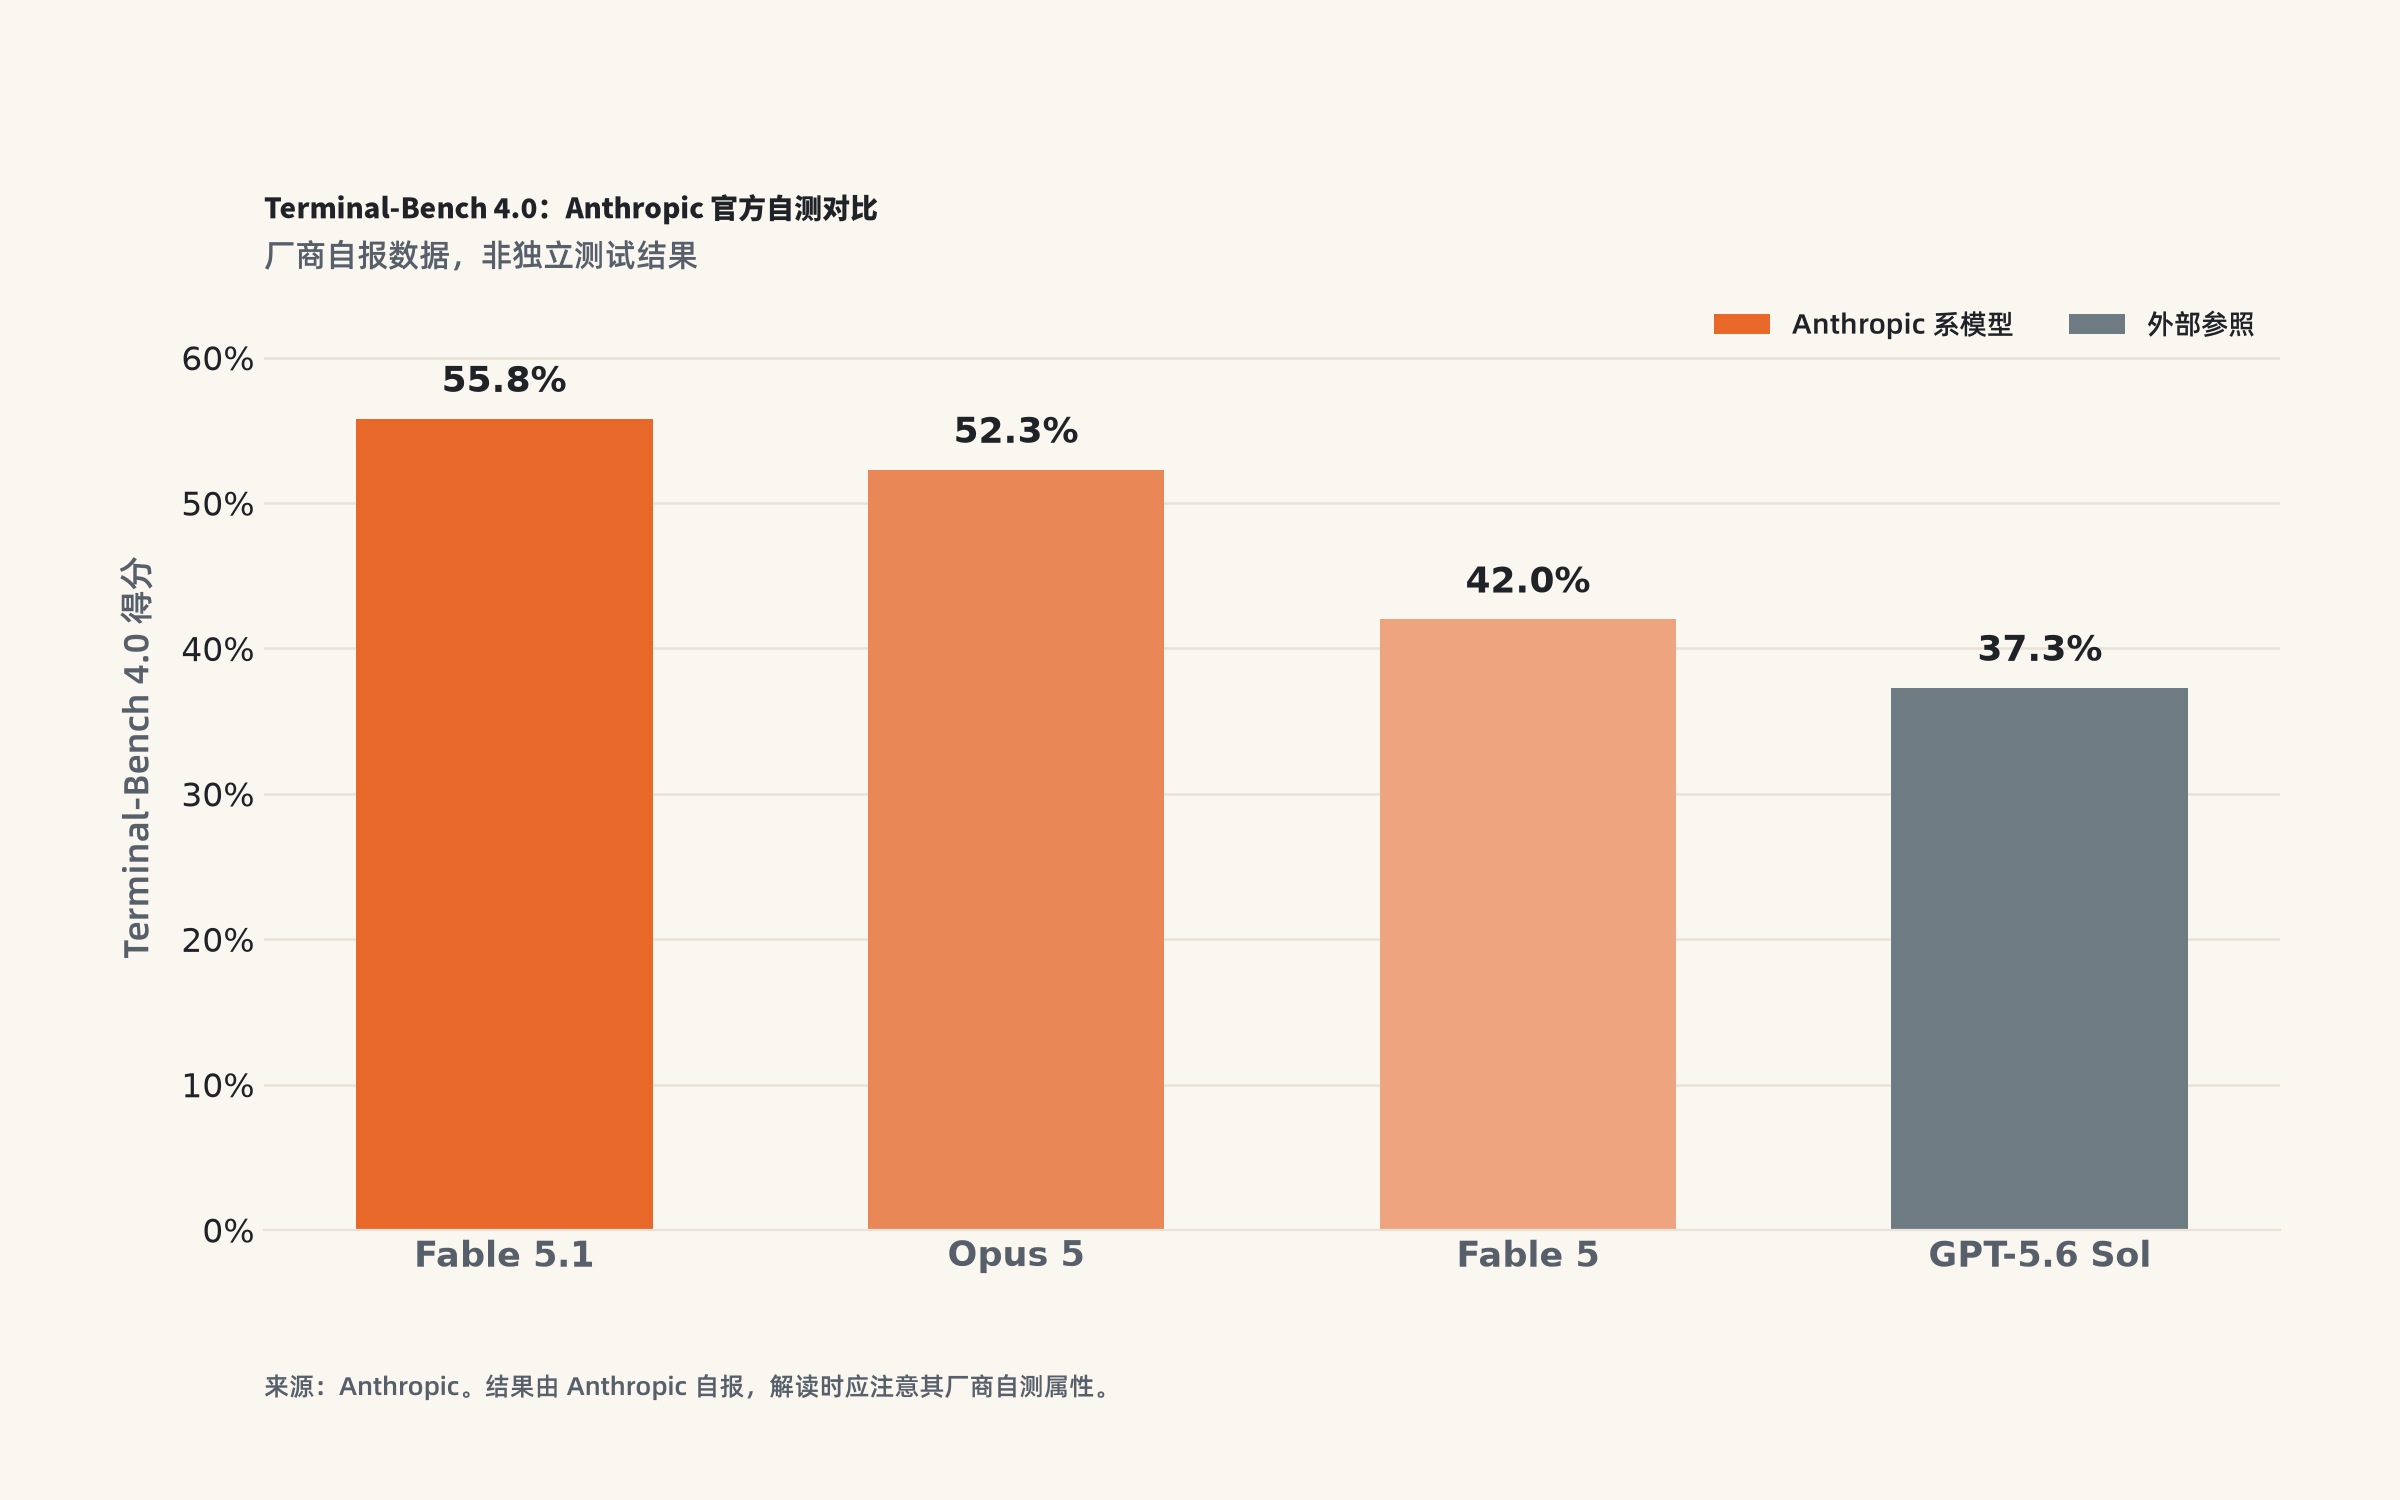
能力跃迁目前主要来自厂商自己的证据。按 Anthropic 官方自测,在同一 Terminal-Bench 4.0 harness 下,Fable 5.1 为 55.8%,Fable 5 为 42.0%,Opus 5 为 52.3%,GPT-5.6 Sol 为 37.3%。这组结果很亮眼,但它首先是 Anthropic 官方自测,不能冒充独立裁判的结论。相对中立的 LMArena Text Overall 在 2026-09-02 的快照里,排在第 1 名、得分 1508±5 的仍是前身 claude-fable-5,不是刚发布、尚无稳定 Arena 分数的 5.1;不过全球前三名均为 Anthropic 系模型,至少说明其对话与综合文本能力的底座很稳。
比跑分更有分量的是 Claude Code。npm 最新稳定版在 2026-09-01 到了 2.1.258;Anthropic 在 2025年11月披露,这款上线约六个月的产品已达到 10 亿美元 run-rate revenue,企业客户包括 Netflix、Spotify、KPMG、L'Oréal、Salesforce。同日宣布收购 Bun 时,Anthropic 还承诺让它继续采用 MIT 许可证开源。再结合 Anthropic 于 2026-02-12 完成的 300 亿美元 Series G 融资及 3800 亿美元投后估值,它显然在把模型、开发工具和运行时基础设施拧成一条链。
市场份额也支持这种判断,但要看清数据性质。Menlo Ventures 的《2025 State of Generative AI in Enterprise》估算,Anthropic 在美国企业 LLM 支出中的份额从 2024 年的 24% 升至 2025 年的 40%。这是市场研究机构的估算,不是 Anthropic 审计收入,而且 Menlo Ventures 本身也是 Anthropic 投资方之一。
OpenAI:模型分层之外,Codex 正在长成平台
OpenAI 在 2026-07-09 发布 GPT-5.6 系列:Sol、Terra、Luna 分别对应旗舰、均衡和高吞吐低成本。三档上下文窗口均为 1,050,000 token,最多输入 922,000、输出 128,000,并提供 none、low、medium、high、xhigh、max 六档推理强度,知识截止日为 2026-02-16。
Sol 的输入、缓存输入、输出价格是 $4、$0.40、$20/百万 token,且这是至少持续到 2026-11-21 的促销价;Terra 为 $2、$0.20、$12;Luna 为 $0.20、$0.02、$1.20。这个梯度很实用:同一套 API 语义下,团队可以按任务价值分配推理预算,而不必把所有请求都送进最贵模型。
第三方 Artificial Analysis Intelligence Index 给出的 GPT-5.6 Sol(max)评分为 61 分,精确值 60.93,来自 v4.1.1 的 9 项综合评测。Terminal-Bench 2.0 上,Codex Agent + GPT-5.6 Sol(max)得到 37.27%,即 123/330。后者是“Agent 工具加模型”的系统成绩,并非裸模型分数,这个区别很关键。
编程线上还有 GPT-5.3-Codex:官方定位为“最强 Agent 编程模型”,400K 上下文窗口,仅支持 Responses API,输入、缓存输入、输出分别为 $1.75、$0.175、$14;Pro 订阅用户另有 GPT-5.3-Codex-Spark 研究预览版,但没有公开跑分。Codex 已形成 CLI、IDE 扩展、桌面 App 与 Web/Cloud 的完整矩阵。开源 CLI 最新稳定版为 0.152.1,GitHub 在 2026-09-02 查询时有 120,864 stars 与 18,517 forks——这只能说明开源关注度,不能当成用户数。
OpenAI 的护城河还在采购路径。GPT-5.6 已成为 Microsoft 365 Copilot 的首选模型,可通过 Oracle Cloud 承诺额度采购部署;Samsung 在全球部署 ChatGPT Enterprise 与 Codex,NTT DATA 约 9,000 名员工使用。2026-06-11 宣布计划收购 Ona,也是为了补上 Codex 安全、持久的云端执行环境。至于 2026-08-13 预览的 Cerebras GPT-5.6 Sol Ultrafast 层,最高 14 倍速度、每秒输出 750 token,均是官方引用的供应商规格,并非独立测试。
Google:多模态底座与异步 Agent 配套推进
Google 当前旗舰仍是 2026-02-19 发布、处于预览阶段的 Gemini 3.1 Pro,而不是“即将推出”的 Gemini 3.5 Pro。前者支持 1M 输入上下文、64K 输出,以及文本、图像、视频、音频和 PDF;更新的 Gemini 3.7 Flash 属于规模化低成本 Agent 档位,不能用版本号把它误判为旗舰替代者。
Google 官方自测的结果均为单次尝试,包括:SWE-bench Verified 80.6%、SWE-bench Pro Public 54.2%、使用 Terminus-2 harness 的 Terminal-Bench 2.0 为 68.5%、APEX-Agents 33.5%、经 ARC Prize Verified 的 ARC-AGI-2 为 77.1%。这些数字展示了上限,却仍是 Google 自测,且仅为单次尝试。
Google 的看点其实是工具拼图:Apache 2.0 开源的 Gemini CLI 最新稳定版 v0.58.0;Antigravity 是面向多 Agent 与复杂应用开发的 AI 原生平台;Jules 则可在后台处理代码仓库并提交 PR。它们与 Google Cloud、Workspace 的结合,让 Gemini 不只是一个聊天框里的多模态模型。
SpaceXAI:Grok 押注长任务,也押注 Cursor
原 xAI 现以 SpaceXAI 为官方名称。其 2026-08-12 发布的 Grok 4.6 面向长时程 Agent、多步骤研究、跨代码库工作和交互式或视觉应用生成,并已接入 Cursor、Grok Build、OpenRouter、Vercel、Cloudflare。
第三方 Artificial Analysis Intelligence Index 给它约 61 分,精确值 60.923,与 GPT-5.6 Sol 的 60.930 基本持平。SpaceXAI 在同一公告表格中自报,CursorBench v3.2 为 69.9%,DeepSWE v1.1 为 65.9%,FrontierCode v1.1 Extended 为 61.3%,Terminal-Bench v3.0 为 26.0%。这里不能拿最后一项直接撞上 Anthropic 的 Terminal-Bench 4.0 或 OpenAI 的 Terminal-Bench 2.0:版本和 harness 不同,小数点看似精确,比较本身却不成立。
编程侧的 Grok Code Fast 1 发布于 2025-08-28,首发合作方包括 GitHub Copilot、Cursor、Cline、Roo Code、Kilo Code、opencode、Windsurf。其 SWE-bench Verified 70.8% 同样是官方自报并使用自有 harness,不宜跨表硬比。
国内模型:综合榜之外,中文榜更值得细看
国产阵营并非同步同速。Kimi K3 强调 Agent 编程与知识工作,并铺开 Kimi Code、Kimi Agent、Kimi Agent Swarm、Kimi Claw;GLM-5.3 主攻编程 Agent、工具调用与长流程执行,GLM Coding Plan 可接 Claude Code、Codex、Cline、OpenCode,$18/月起;闭源的 Qwen3.8-Max 背后还有部分以 Apache-2.0 开放权重的 Qwen3.x,以及 Qwen3-Coder,但目前没有可靠公开来源证明阿里拥有独立对标 Claude Code 或 Codex 的终端 Agent。
DeepSeek V4-Pro 于 2026-08-13 正式可用(GA),原生兼容 OpenAI Responses API,可一键配置接入 Codex。输入未命中缓存为 $0.22-0.66/百万 token,输出为 $0.66-1.32/百万 token,另有 2026-08-21 上线的 V4-Flash-Vision-Exp 多模态实验分支。MiniMax M3 主打编程与 Agent 前沿、原生多模态和 1M token 上下文窗口,保底 512K,并有 MiniMax Code。厂商自报 PostTrainBench 37.1、总榜第 3,仅次于 Opus 4.7 的 42.4 与 GPT-5.5 的 39.3;这套比较用的是旧代际模型,且其官网对开放状态的措辞并不完全一致,更准确的说法是“宣布开放权重方向,完整发布状态待观察”。
字节 Seed2.1 于 2026-06-23 发布,官方定位新一代 Agent 模型,覆盖通用 Agent、端到端编程和原生多模态;其领先说法属于厂商自报,LMArena 又没有可确认条目,因此不拿具体分数填空。百度 ERNIE 5.1 有 Arena 条目,但缺少可确认精确发布日期和价格的一手发布页;腾讯 HY3 仍处于预览阶段;Step-3.5-Flash 在 LMArena 标为 Apache-2.0。零一万物则因未能确认 2026 年同期旗舰的可靠公开数据,不进入排名。
排行榜要看梯队,不要迷信小数点
横评最诱人的做法,是把所有数字塞进一列,再算出一个冠军。但模型跑分带着各自的测试版本、harness 和发布日期;刚发布的型号尤其缺少稳定独立数据。更负责任的主轴,是采用所有厂商处于同一盲测协议下的 LMArena Text Overall 2026-09-02 快照,再用 Agent 与编程测试补充画像。结果应当是梯队,而不是伪装成科学的精确总名次。
| 梯队 | 厂商与代表模型 | 判断依据 |
|---|---|---|
| 第一梯队:全球前沿 | Anthropic Fable 5.1/Mythos 5.1;OpenAI GPT-5.6 Sol;Google Gemini 3.1 Pro;SpaceXAI Grok 4.6 | Anthropic 前身 Fable 5 位列 LMArena 全球第 1;GPT-5.6 Sol 与 Grok 4.6 的第三方指数约 61 分;Gemini 展现出强劲的官方自测编程能力。四家互有胜负,没有全维度碾压者 |
| 第二梯队:逼近前沿 | Kimi K3;GLM-5.3;Qwen3.8-Max | LMArena 全球第 10、第 17、第 20,与榜首点估计差分别为 19、26、29 分 |
| 第三梯队:稳健但差距拉开 | ERNIE 5.1;DeepSeek V4-Pro;MiniMax M3 | LMArena 全球第 40、第 50、第 77;DeepSeek 的价格优势尤其突出 |
| 第四梯队:早期或待观察 | HY3 Preview;Step-3.5-Flash;零一万物等 | 前两者为第 130、第 154;零一万物未能确认最新进展,不纳入排名 |
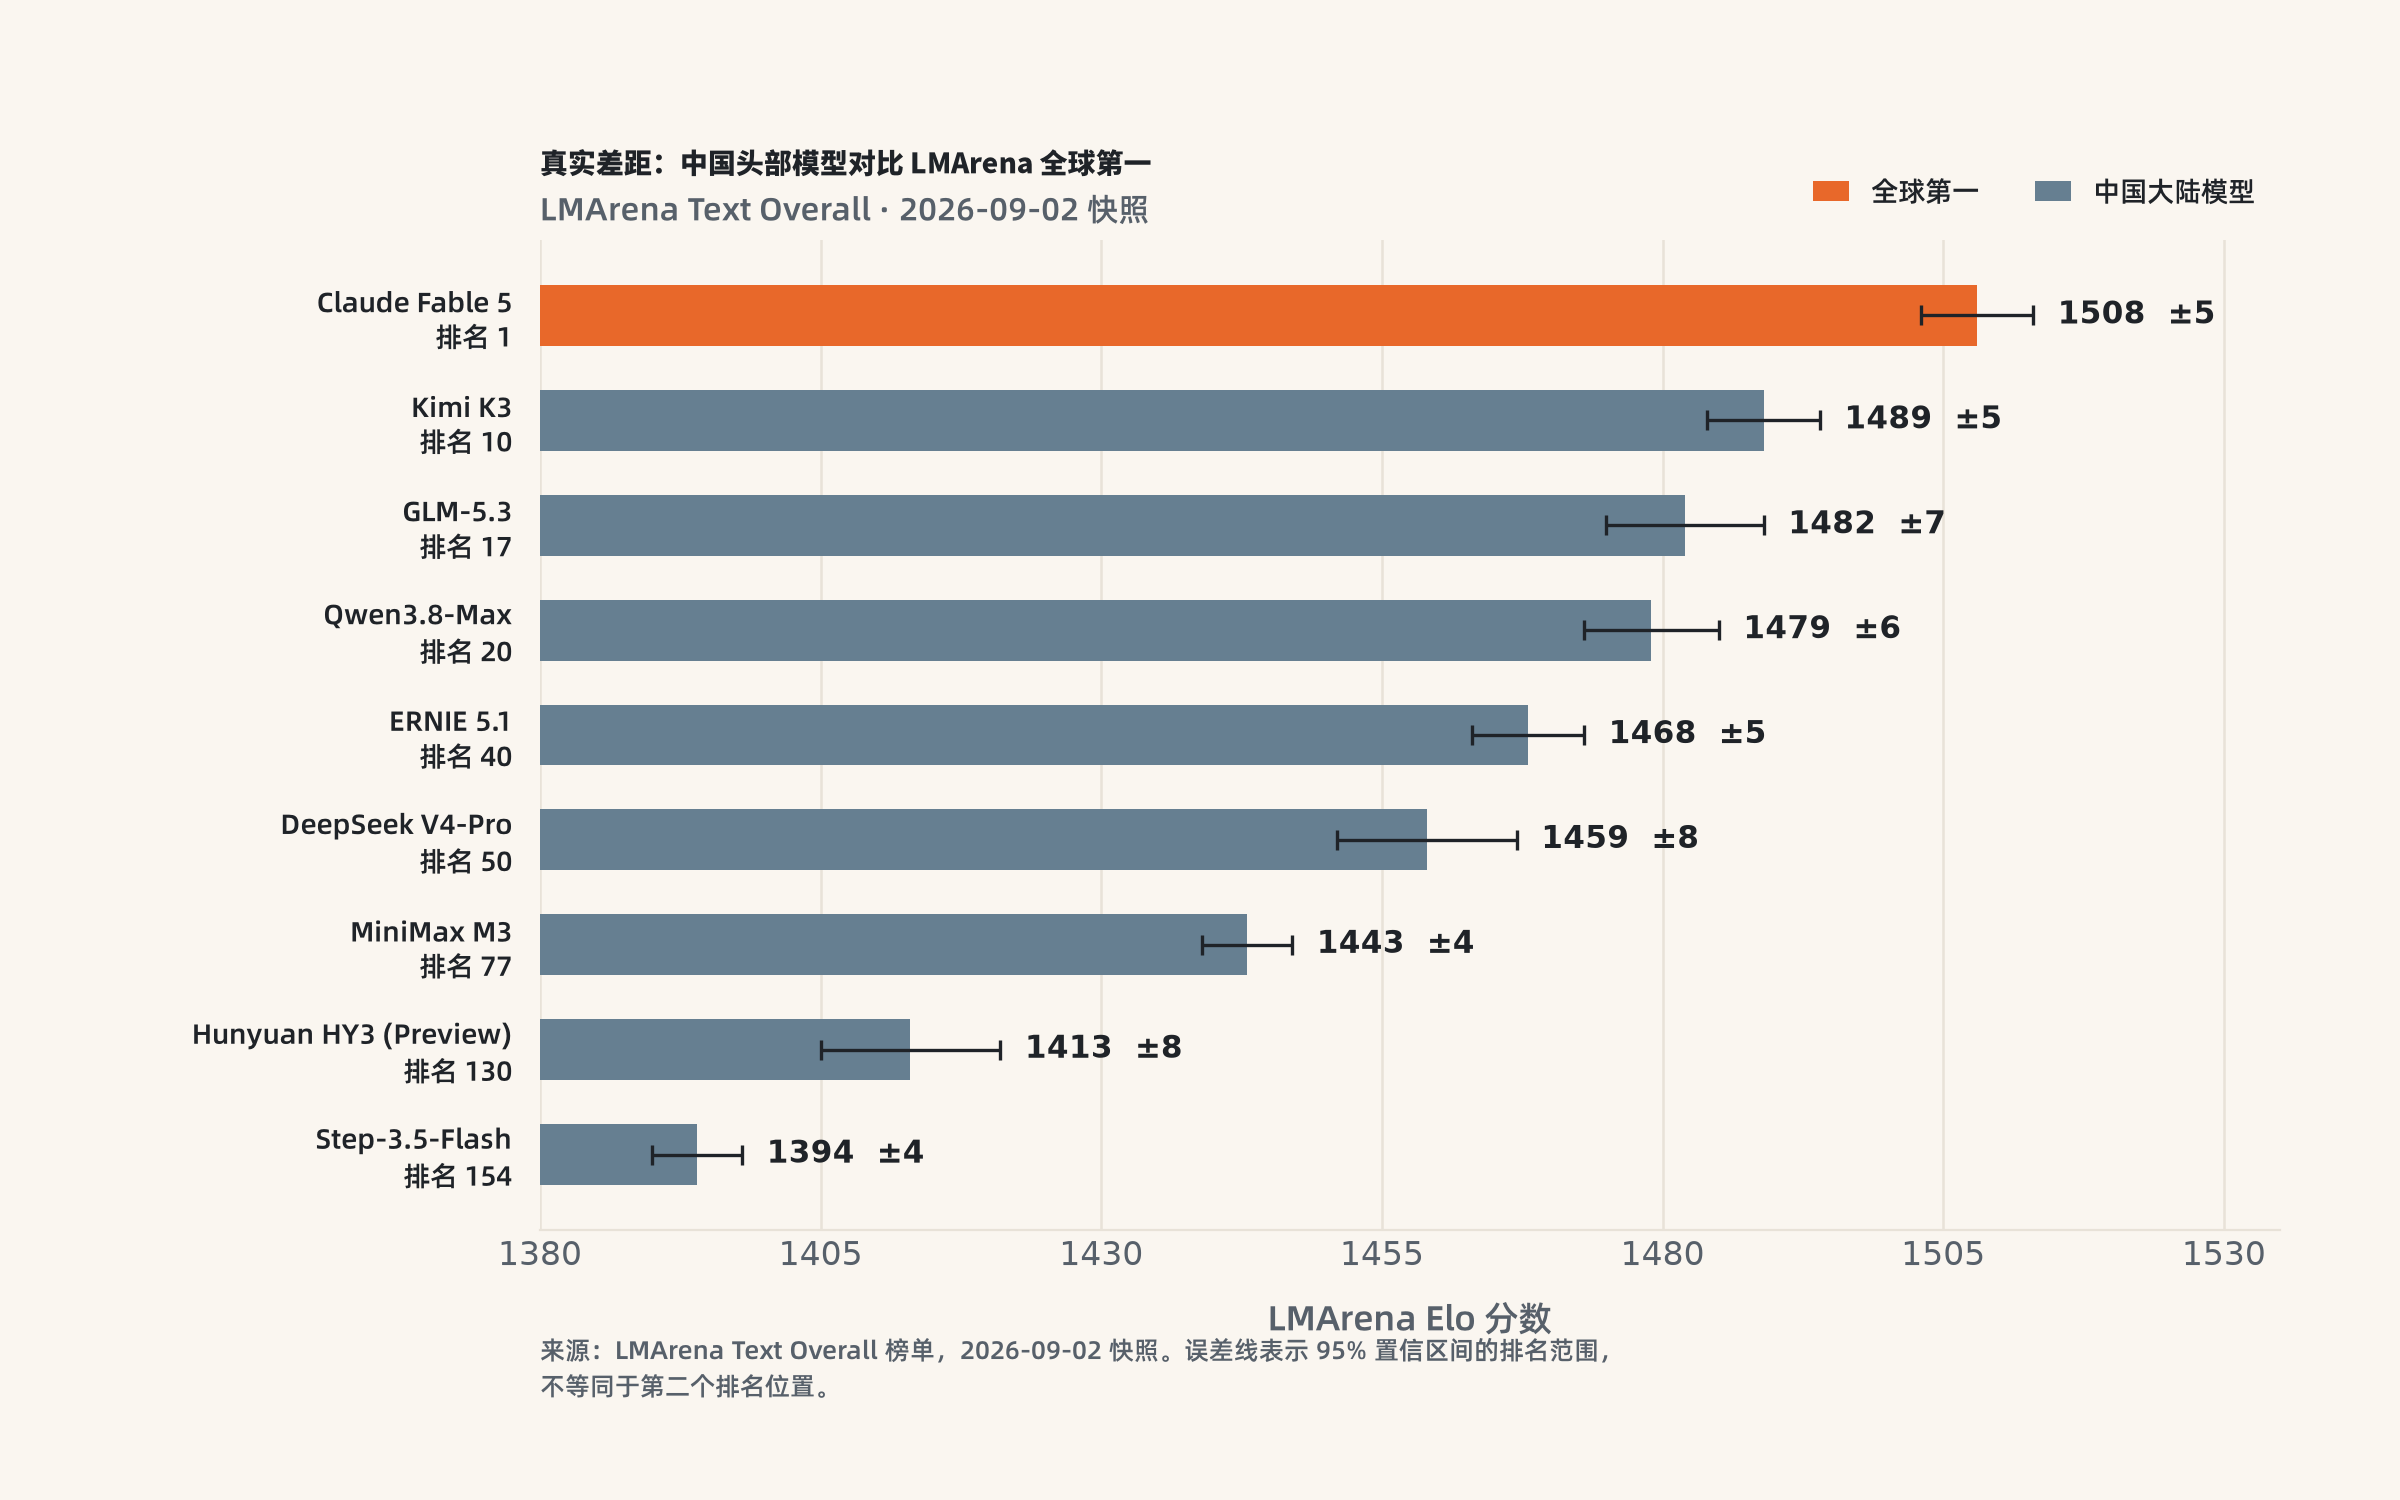
第二梯队的名次数差看着很大,分数却不是断层。Kimi K3 Max 为 1489±5,GLM-5.3 Max 为 1482±7,Qwen3.8-Max 为 1479±6,对榜首 1508±5 的点估计差是 19–29 分。LMArena 头部区域对微小分差很敏感,因此更准确的描述是“肉眼可辨,但并非断层式”。
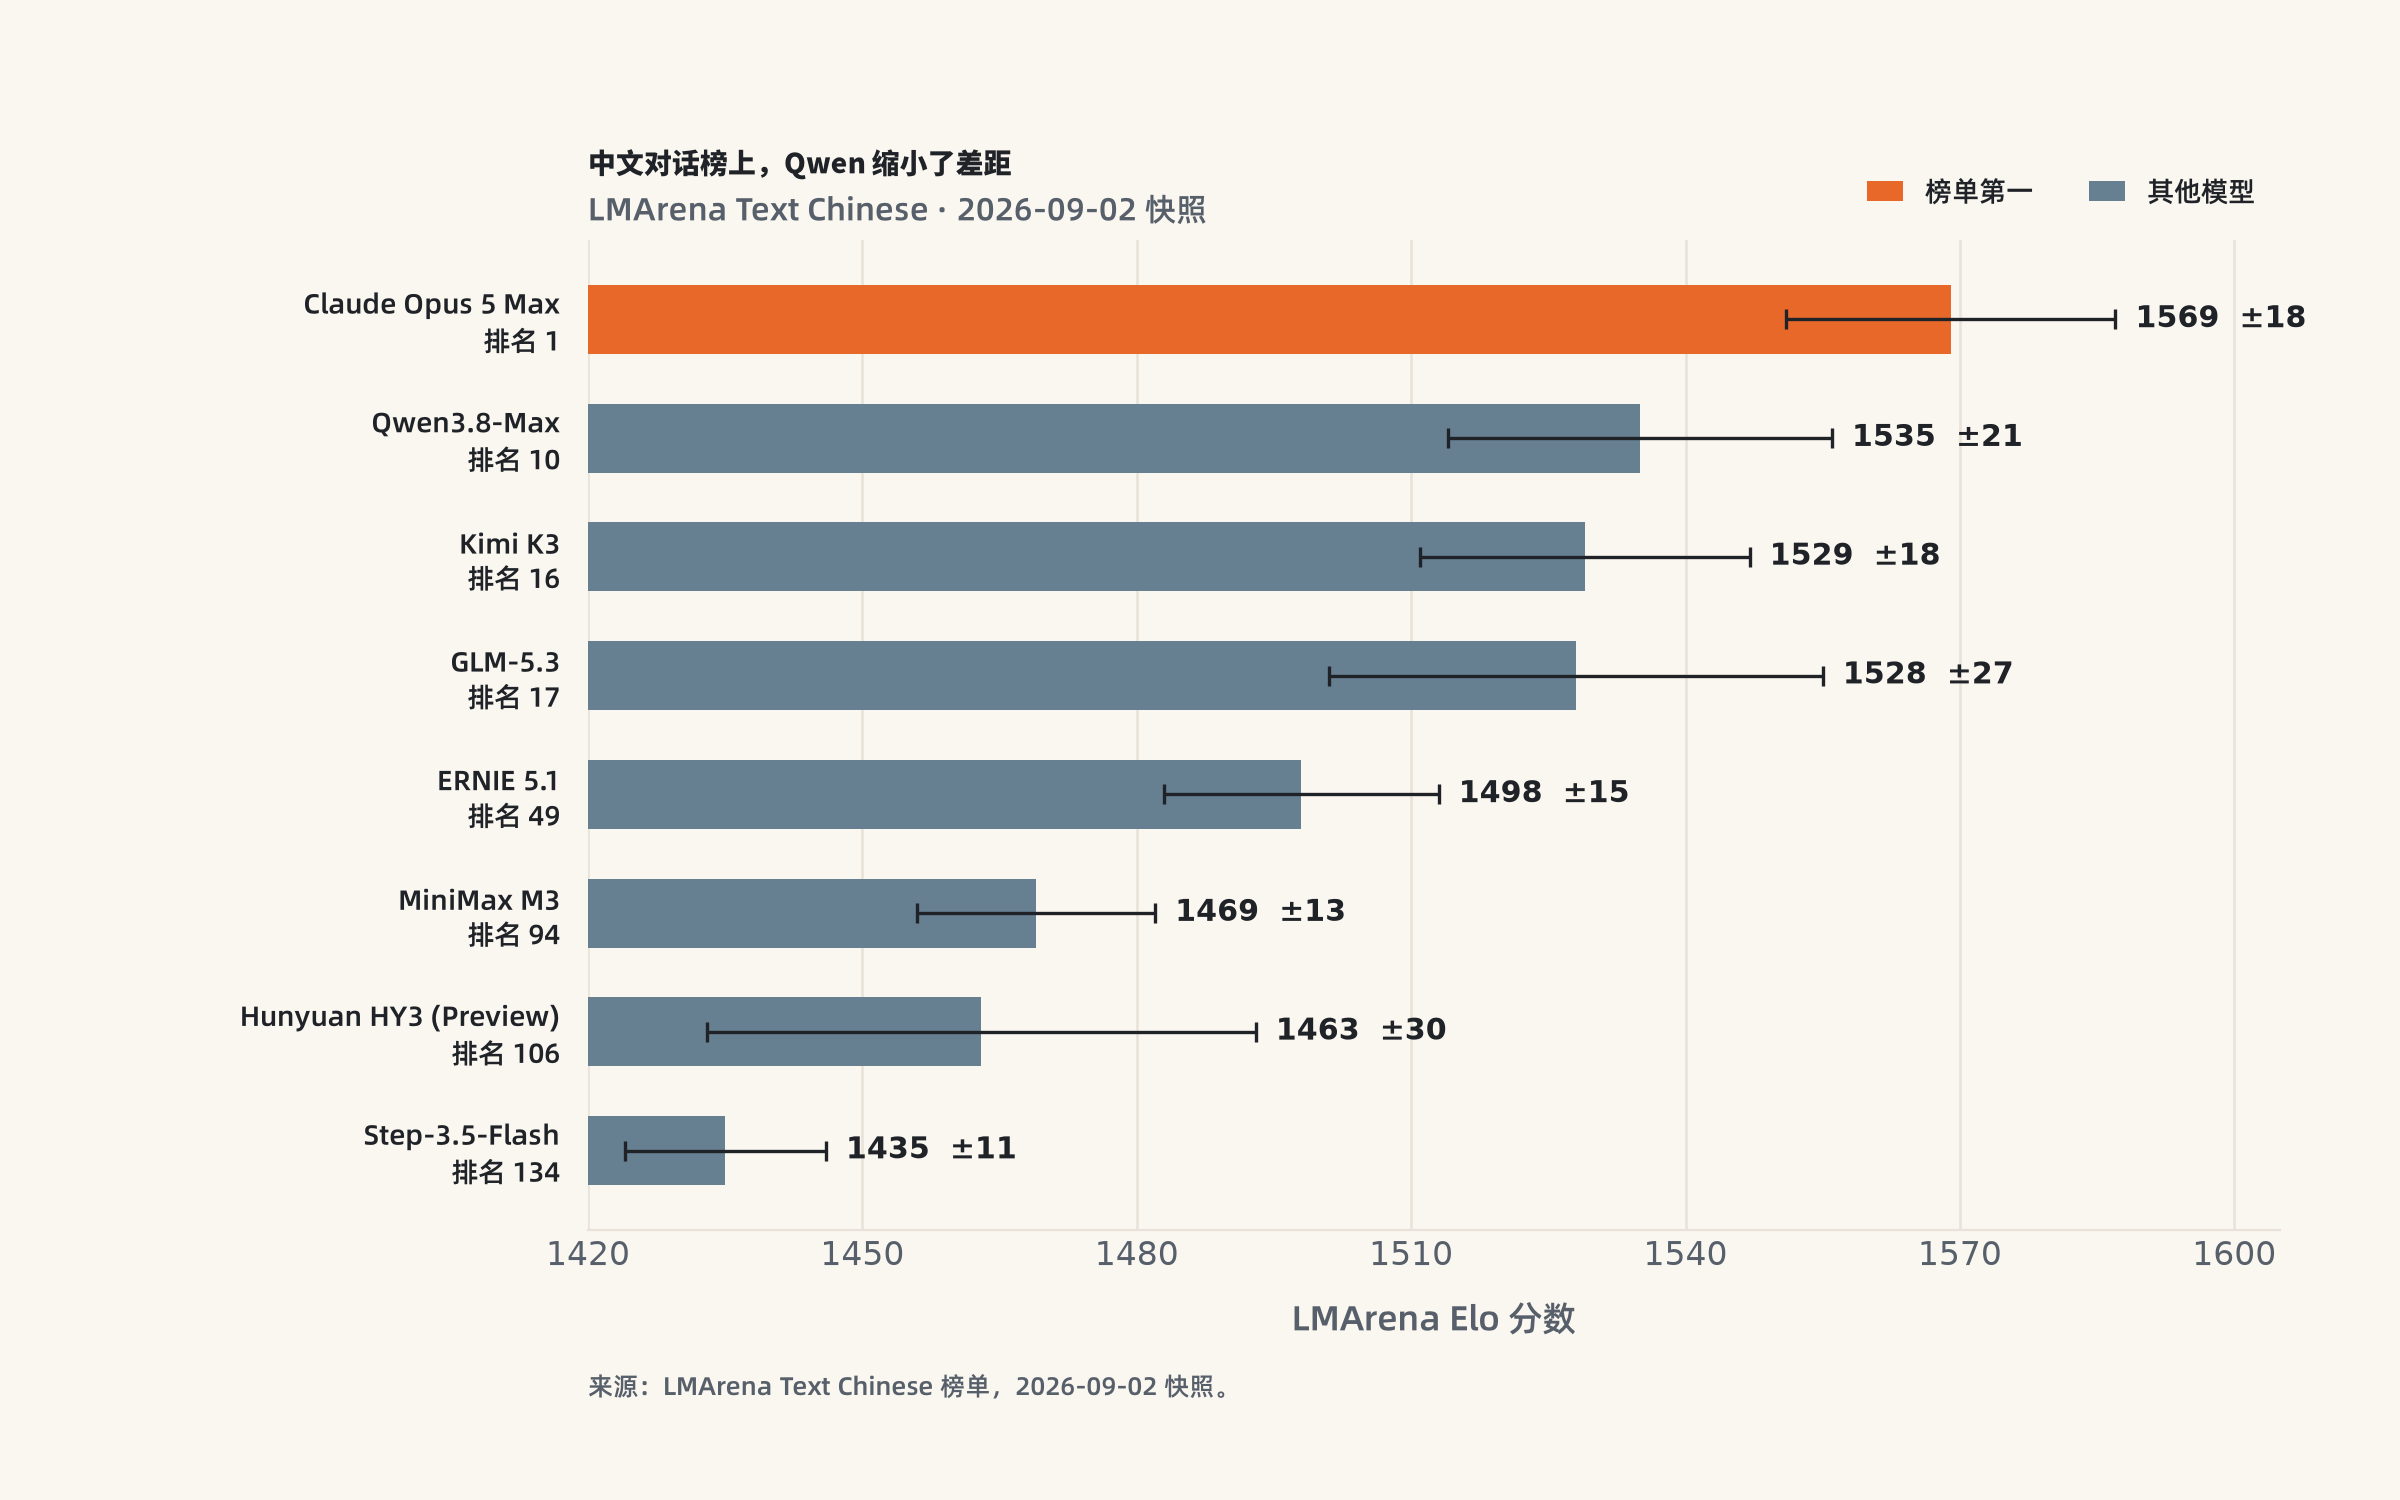
中文榜还改写了内部顺序。Text Chinese 的榜首是 Claude Opus 5 Max,1569±18;Qwen3.8-Max 以第 10 名、1535±21 分成为排名最高的中国大陆模型,超过第 16 名、1529±18 分的 Kimi K3 和第 17 名、1528±27 分的 GLM-5.3。对中文开发者而言,这比综合榜更有现实意义:头部国产模型在中文语境中的距离,比全球名次呈现得更近。
三个名字,两个最容易传错的故事
“xAI 收购 Cursor”是错的。买家是 SpaceX,而不是 xAI。Reuters 于 2026-06-16 报道 SpaceX 与 Cursor 母公司 Anysphere 签署 600 亿美元全股票收购协议;Cursor 在 2026-08-14 官宣完成交易,并称收购过程始于当年 4 月双方合作训练模型。收购前,Cursor 于 2025-11-13 宣布 Series D,融资 23 亿美元、投后估值 293 亿美元。交易后 Cursor 没有停运,而是继续作为产品入口,并利用 SpaceX 的算力训练模型,Grok 4.6 也已接入。OpenAI 随后在 2026-08-29 宣布计划终止向 SpaceX 旗下 Cursor 供应模型,原本的多模型关系由此生变。混淆的一个原因,是 xAI 官网如今也挂着“SpaceXAI”的名头;但公司整合后的品牌变化,不能反推交易买方。
“Groq 就是 Grok”也完全错误。Groq 是 2016年成立、由 Jonathan Ross 创办的独立 AI 推理基础设施公司,做 LPU 芯片与 GroqCloud;Grok 才是 SpaceXAI 的大模型品牌。Groq 于 2026-06-22 宣布获得 6.5 亿美元新增长资本;此前在 2025-12-24 与 NVIDIA 达成非独家推理技术许可协议,创始人与部分团队加入 NVIDIA,但 Groq 官方称公司继续独立运营。它与 Meta 合作为 Llama API 加速时宣称最高 625 token/秒,并自报运营 13 个数据中心、服务超 500 万开发者——这些均是厂商自报,非独立审计。两者除了读音相近,没有关系。
Agent 生态地图:有人造整车,有人专供发动机
| 公司 | 终端与入口 | 云端/异步与 IDE | 路线判断 |
|---|---|---|---|
| Anthropic | Claude Code | 后台/多 Agent、定时任务、VS Code/JetBrains 插件 | 自家模型与工具深度绑定,并以 Bun 补基础设施 |
| OpenAI | 开源 Codex CLI | Codex Web/Cloud、IDE 扩展、桌面 App | ChatGPT 订阅额度与 API 双轨 |
| 开源 Gemini CLI | Jules、Antigravity | 与 Cloud、Workspace 深度整合 | |
| SpaceXAI | Grok Build、Cursor | Cursor 一体化 IDE 工作流 | 模型与入口一体化 |
| 智谱 | 借用主流工具入口 | 兼容 Claude Code、Codex、Cline 等 | 用熟悉的壳子替换更便宜的模型 |
| 月之暗面 | Kimi Code | Kimi Agent Swarm 等 | Agent 产品矩阵化 |
| 阿里 | Qwen3-Coder 与云端 API | 未确认独立终端 Agent | 模型加云服务,位置介于两条路线之间 |
| DeepSeek | 无自有 CLI | 适配 Claude Code、Codex、Copilot CLI | 靠被集成扩大覆盖 |
| MiniMax | MiniMax Code | 支持 Claude Code、Codex CLI、Cursor 等 | 开放权重方向加低价 |
这张图揭示了两种生意。Anthropic、OpenAI、Google、SpaceXAI/Cursor 想把模型、壳子和执行环境一起拿下;智谱、DeepSeek、MiniMax 则主动进入别人已经建立的工作流,争夺底层模型席位。阿里介于两者之间。前一种路线控制体验,切换成本也更高;后一种路线把选择权留给开发者,竞争压力则会直接落到价格、兼容性与稳定性上。
如果今天就要选,我会这样分
日常写代码、跑脚本,预算敏感且以中文为主,我会先试 GLM Coding Plan、DeepSeek V4 或 Kimi Code。DeepSeek V4-Flash 输入低至 $0.007-0.22/百万 token,头部国产模型在中文榜的表现也说明,“便宜”已经不必自动等于“明显笨一截”。合规、内网集成和中文指令习惯,往往比综合榜上的若干名次更影响每天的手感。
复杂长任务需要持续自主执行,而且能接受更高成本,我会优先看 Claude Code + Fable 5.1。理由不是单押厂商跑分,而是把 Anthropic 官方自测 Terminal-Bench 4.0 从上一代 42.0% 到 55.8% 的变化,与 Claude Code 10 亿美元 run-rate revenue 所代表的企业采用放在一起看。它更适合那种“交代一个复杂任务,然后去做别的事”的工作方式。当然,价格也明确站在最高一档。
超长文档与图片、视频、PDF 混合输入,则更值得试 Gemini 3.1 Pro + Antigravity/Jules。Google 的优势不只是多模态输入,而是开发平台、异步仓库 Agent、Cloud 与 Workspace 能否形成连贯体验。
已经离不开 Cursor、重视从想法到可视化应用的团队,Grok 4.6 的意义会大于一张裸模型成绩单。SpaceX 收购 Cursor 后,模型与 IDE 的绑定更深,这条线卖的是完整工作流。
企业采购需要合规审计通道时,GPT-5.6 进入 Microsoft 365 Copilot、可使用 Oracle Cloud 既有承诺采购的能力非常实际。模型选型经常不是实验室里谁多得几分,而是谁能进入已经存在的合同、权限与审计体系。
数据不能出境、必须国产化部署,也不再意味着要默认牺牲大量能力。Kimi、GLM、Qwen 与国际一线的差距已经缩到体感可辨、却并非断层的范围,中文场景下还会更小。真正需要验证的,是你的仓库、任务链和基础设施,而不是抽象地争论哪个品牌“最强”。
光标最终落在工作流上
九月发布季最有价值的信号,不是又多了几个旗舰名字,而是模型正在变成 Agent 系统中的可替换部件。最强模型可能赢下一次困难推理,完整工具链才可能赢下每天发生的开发工作。
开发者因此不必寻找一个永久冠军。高风险长任务选稳定的端到端系统,批量日常任务选择成本更合适的模型,多模态和企业场景再按生态与采购路径分流。未来的差异化会越来越少停留在聊天窗口里的惊艳回答,越来越多体现在:任务能否持续运行,失败后能否恢复,权限是否可控,结果是否真的能交付。
发布页总会被下一张发布页覆盖。留下来的,是那个你敢把真实工作交出去的系统。
参考资料
Anthropic
- Anthropic — Claude Fable and Mythos 5.1(2026-09-01)
- Anthropic — Claude Fable 5 and Mythos 5(2026-06-09)
- Anthropic — Claude Opus 5(2026-07-24)
- Anthropic — Claude Sonnet 5(2026-06-30)
- Anthropic — Claude Haiku 4.5(2025-10-15)
- npm — @anthropic-ai/claude-code(2026-09-02)
- Anthropic GitHub — Claude Code Changelog(2026-09-02)
- Anthropic — Anthropic acquires Bun as Claude Code reaches $1B milestone(2025-12-03)
- Menlo Ventures — 2025 State of Generative AI in the Enterprise(2025-12-09)
- Anthropic — $30 billion Series G at $380 billion post-money valuation(2026-02-12)
OpenAI
- OpenAI — Introducing GPT-5.6(2026-07-09)
- OpenAI API Docs — GPT-5.6 Sol(2026-09-02)
- OpenAI API Docs — GPT-5.6 Terra(2026-09-02)
- OpenAI API Docs — GPT-5.6 Luna(2026-09-02)
- OpenAI API Docs — GPT-5.3-Codex(2026-09-02)
- Artificial Analysis — GPT-5.6 Sol(2026-09-02)
- Terminal-Bench — Terminal-Bench 2.0 leaderboard(2026-09-02)
- OpenAI Codex GitHub — v0.152.1(2026-09-01)
- OpenAI Codex — GitHub repository(2026-09-02)
- OpenAI — GPT-5.6 in Microsoft 365 Copilot(2026-07-10)
- OpenAI — OpenAI on Oracle Cloud(2026-06-11)
- OpenAI — Samsung Electronics deploys ChatGPT Enterprise and Codex(2026-06-22)
- OpenAI — NTT DATA(2026-07-22)
- OpenAI — OpenAI to acquire Ona(2026-06-11)
- OpenAI — Previewing GPT-5.6 Sol Ultrafast(2026-08-13)
- Reuters — OpenAI to end model partnership with SpaceX-owned Cursor(2026-08-29)
- Google DeepMind — Gemini 3.1 Pro model card(2026-02-19)
- Google DeepMind — Gemini models(2026-09-02)
- Google DeepMind — Gemini Pro(2026-09-02)
- Google — Gemini CLI(2026-09-02)
- Google — Gemini CLI Releases(2026-09-02)
- Google — Jules(2026-09-02)
SpaceXAI · xAI · Groq · Cursor
- SpaceXAI — Grok 4.6(2026-08-12)
- xAI — Grok Code Fast 1(2025-08-28)
- Artificial Analysis — Grok 4.6(2026-09-02)
- Cursor — Joining SpaceX(2026-08-14)
- Cursor — Series D(2025-11-13)
- Reuters — SpaceX to buy Cursor parent Anysphere for $60 billion(2026-06-16)
- Groq — Company(2026-09-02)
- Groq — $650M growth capital(2026-06-22)
- Groq — Non-exclusive NVIDIA inference technology license(2025-12-24)
- Groq — Meta and Groq collaborate on the Llama API(2025-04-29)
国内模型
- LMArena — Text Overall leaderboard(2026-09-02)
- LMArena — Text Chinese leaderboard(2026-09-02)
- Z.ai — GLM-5.3 Model API(2026-09-02)
- Z.ai — GLM Coding Plan(2026-09-02)
- Kimi — Kimi K3(2026-09-02)
- Kimi — Agent(2026-09-02)
- Kimi — Agent Swarm(2026-09-02)
- Qwen — Qwen3(2026-09-02)
- Qwen — Qwen3-Coder(2026-09-02)
- DeepSeek — DeepSeek V4-Pro GA(2026-08-13)
- DeepSeek — V4-Flash-Vision-Exp(2026-08-21)
- DeepSeek — Codex integration(2026-09-02)
- DeepSeek — API pricing(2026-09-02)
- ByteDance Seed — Seed2.1(2026-06-23)
- MiniMax — MiniMax M3(2026-09-02)
- MiniMax — MiniMax Code(2026-09-02)