把外部世界接进来:让 Dify 真正调用一条 API
前四集里,"国家信息小助手"已经会理解问题、选择分支、保存会话状态。可它回答"法国有多少人口"时,真正提供事实的仍然是语言模型。
这会留下一个很难靠提示词消除的问题:模型擅长组织语言,却不保证脑海里的数字刚刚更新,也不保证每次都能说清数据口径。只要应用开始回答人口、面积、汇率、库存、订单状态这类会变化或需要追溯的数据,事实就应该来自明确的数据源。
这一集,我们给现有 Chatflow 接入一条真实的国家信息 API。用户输入自然语言,工作流先提取国家名,再向外部服务发出请求,最后把返回的 JSON 整理成可以直接阅读的答案。到这里,Dify 才从一个围绕模型运转的对话画布,变成一个能够连接真实系统的应用编排器。
前情提要:EP4 讲清了环境变量和会话变量的分工:会话变量保存一场对话里发生过什么,环境变量保存应用依赖的固定配置,尤其适合 API Key。上一集故意没有拿假 Key 演示;这一集会让它出现在真正需要鉴权的位置。完整背景可以回看 EP4《别只让数据路过:用变量给 Dify 应用打地基》 的「环境变量保存的不是记忆,而是配置」一节。
| # | 主题 | 一句话 | 状态 |
|---|---|---|---|
| 1 | AI 应用平台通识与选型 | 认知/选型判断力:这个领域是什么、要不要学、怎么定位 | 已发布 |
| 2 | 云版搭第一个 Chatflow 应用 | 5 种应用类型、Start/LLM/Answer、Prompt 分层、发布分发 | 已发布 |
| 3 | 给应用装上"分岔路" | If/Else、问题分类器:写死的规则 vs 交给模型判断 | 已发布 |
| 4 | 变量,这个系列真正的地基 | 会话变量、环境变量、变量聚合器/赋值器 | 已发布 |
| 5 | 把外部世界接进来 | HTTP Request、Code 节点、参数提取器 | ← 你在这里 |
| 6 | 知识库与 RAG 实战 | 文档处理/分段/检索策略/Rerank | 已发布 |
| 7 | 批量处理与循环 | Iteration、Loop、列表操作 | 已发布 |
| 8 | 工具与 Agent | 工具市场、自定义工具、Function Calling/ReAct、双向 MCP | 已发布 |
| 9 | 从 Demo 到生产:运维篇 | DSL 版本管理、执行日志、标注、可观测性、权限 | 已发布 |
| 10 | 私有化部署实战 | Docker Compose、.env、报错排查 |
已发布 |
这一集要改掉哪一段流程
EP4 结束时,"国家名称"分支的正常路径是:
问题分类器 → 条件分支 → LLM → 变量聚合器 → 变量赋值器 → 直接回复
LLM 同时承担了两件事:理解用户问的是哪个国家,以及凭模型知识生成答案。前一件事属于自然语言理解,后一件事属于事实查询。把它们塞在同一个节点里,画布虽然短,数据来源却很难说明。
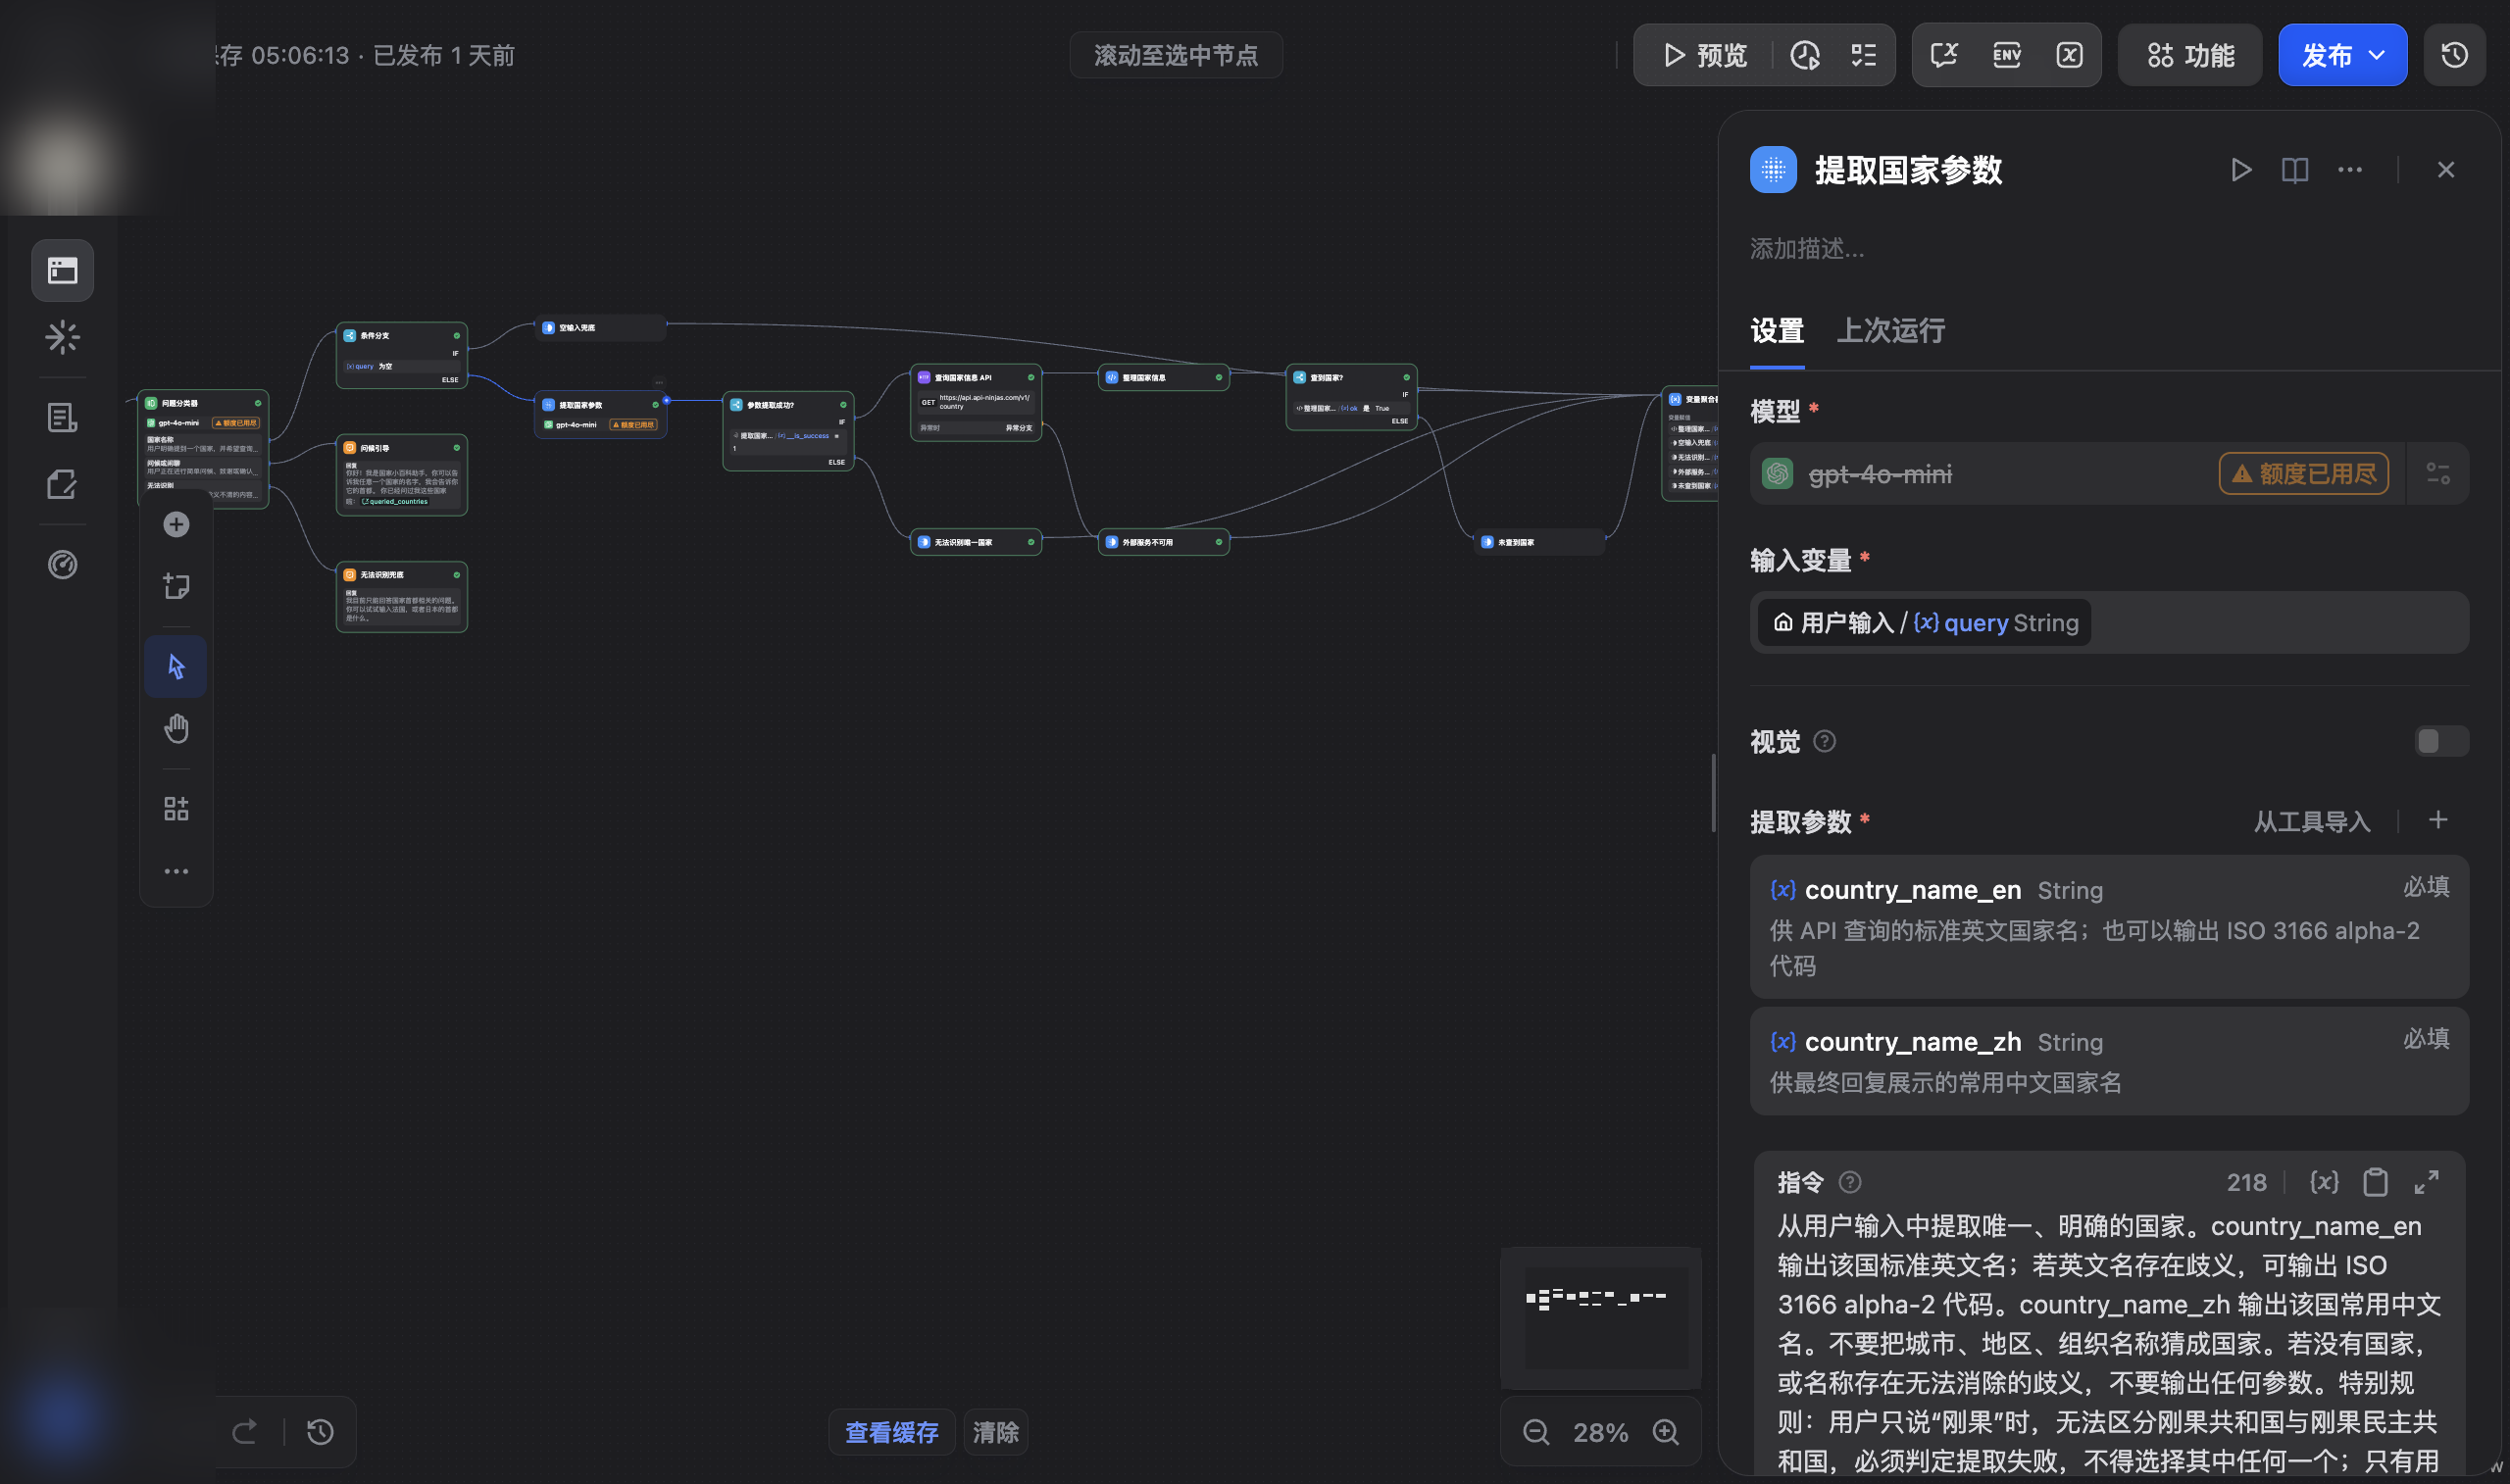
这次保留分类器、空输入兜底、变量聚合器和查询历史,把正常查询路径改成:
参数提取器 → HTTP Request → Code → 变量聚合器 → 变量赋值器 → 直接回复
三种新节点各守一段边界:
- 参数提取器把"日本的首都是什么?"整理成 API 能接收的字段;
- HTTP Request 只负责按协议访问外部服务,并把响应交还工作流;
- Code 只负责解析返回值、处理空结果、统一数字和文本格式。
这条路径比一个 LLM 节点长,却能逐段回答三个工程问题:请求发给了谁,事实从哪里来,原始数据经过了怎样的处理。
先选一条真的需要 Key 的国家信息 API
本例使用 API Ninjas 的 Country API。它接收国家英文名、ISO 3166 两位代码或三位代码,返回首都、货币、人口、国土面积等国家统计数据。
它适合作为这一集的教学 API,有三个原因:
- 调用方式足够简单:一个
GET请求加一个name查询参数; - 鉴权方式足够典型:每次请求都要在
X-Api-KeyHeader 中传入 Key; - 返回值是 JSON 数组,刚好能演示外部响应进入工作流以后还需要做什么。
申请步骤也很短:打开 API Ninjas 注册页 创建免费账户,登录后复制账户提供的 API Key。官网当前公布的免费方案无需付款信息,每月包含 3,000 次 API 调用,并限制为每小时 100 次;使用免费层时需要标注来源(Attribution required),且不允许商业使用。该方案定位是评估和 Demo。本文案例属于学习演示,如果要把应用用于生产或商业场景,应重新核对官网当时的套餐和许可,不要把教程里的免费额度当成长期合同。
接口地址是:
GET https://api.api-ninjas.com/v1/country
查询美国时,请求大致长这样:
GET /v1/country?name=United%20States HTTP/1.1
Host: api.api-ninjas.com
X-Api-Key: YOUR_API_KEY
官方示例响应是一个数组。我们只取第一项中的几个字段:
[
  {
    "name": "United States",
    "capital": "Washington, D.C.",
    "currency": {
      "code": "USD",
      "name": "US Dollar"
    },
    "population": 331003,
    "surface_area": 9833517
  }
]
这里有一个容易写错的口径:Country API 的 population 按千人计,示例中的 331003 表示约 331,003,000 人;surface_area 的单位是平方公里。Code 节点会负责换算和加千位分隔符,避免把接口原值直接展示给用户。
API 返回的统计值还可能来自不同年份。本文把它用于演示节点的数据流,不把这些数字包装成实时普查结果。生产应用需要进一步确认数据来源、更新时间和业务可接受的精度。
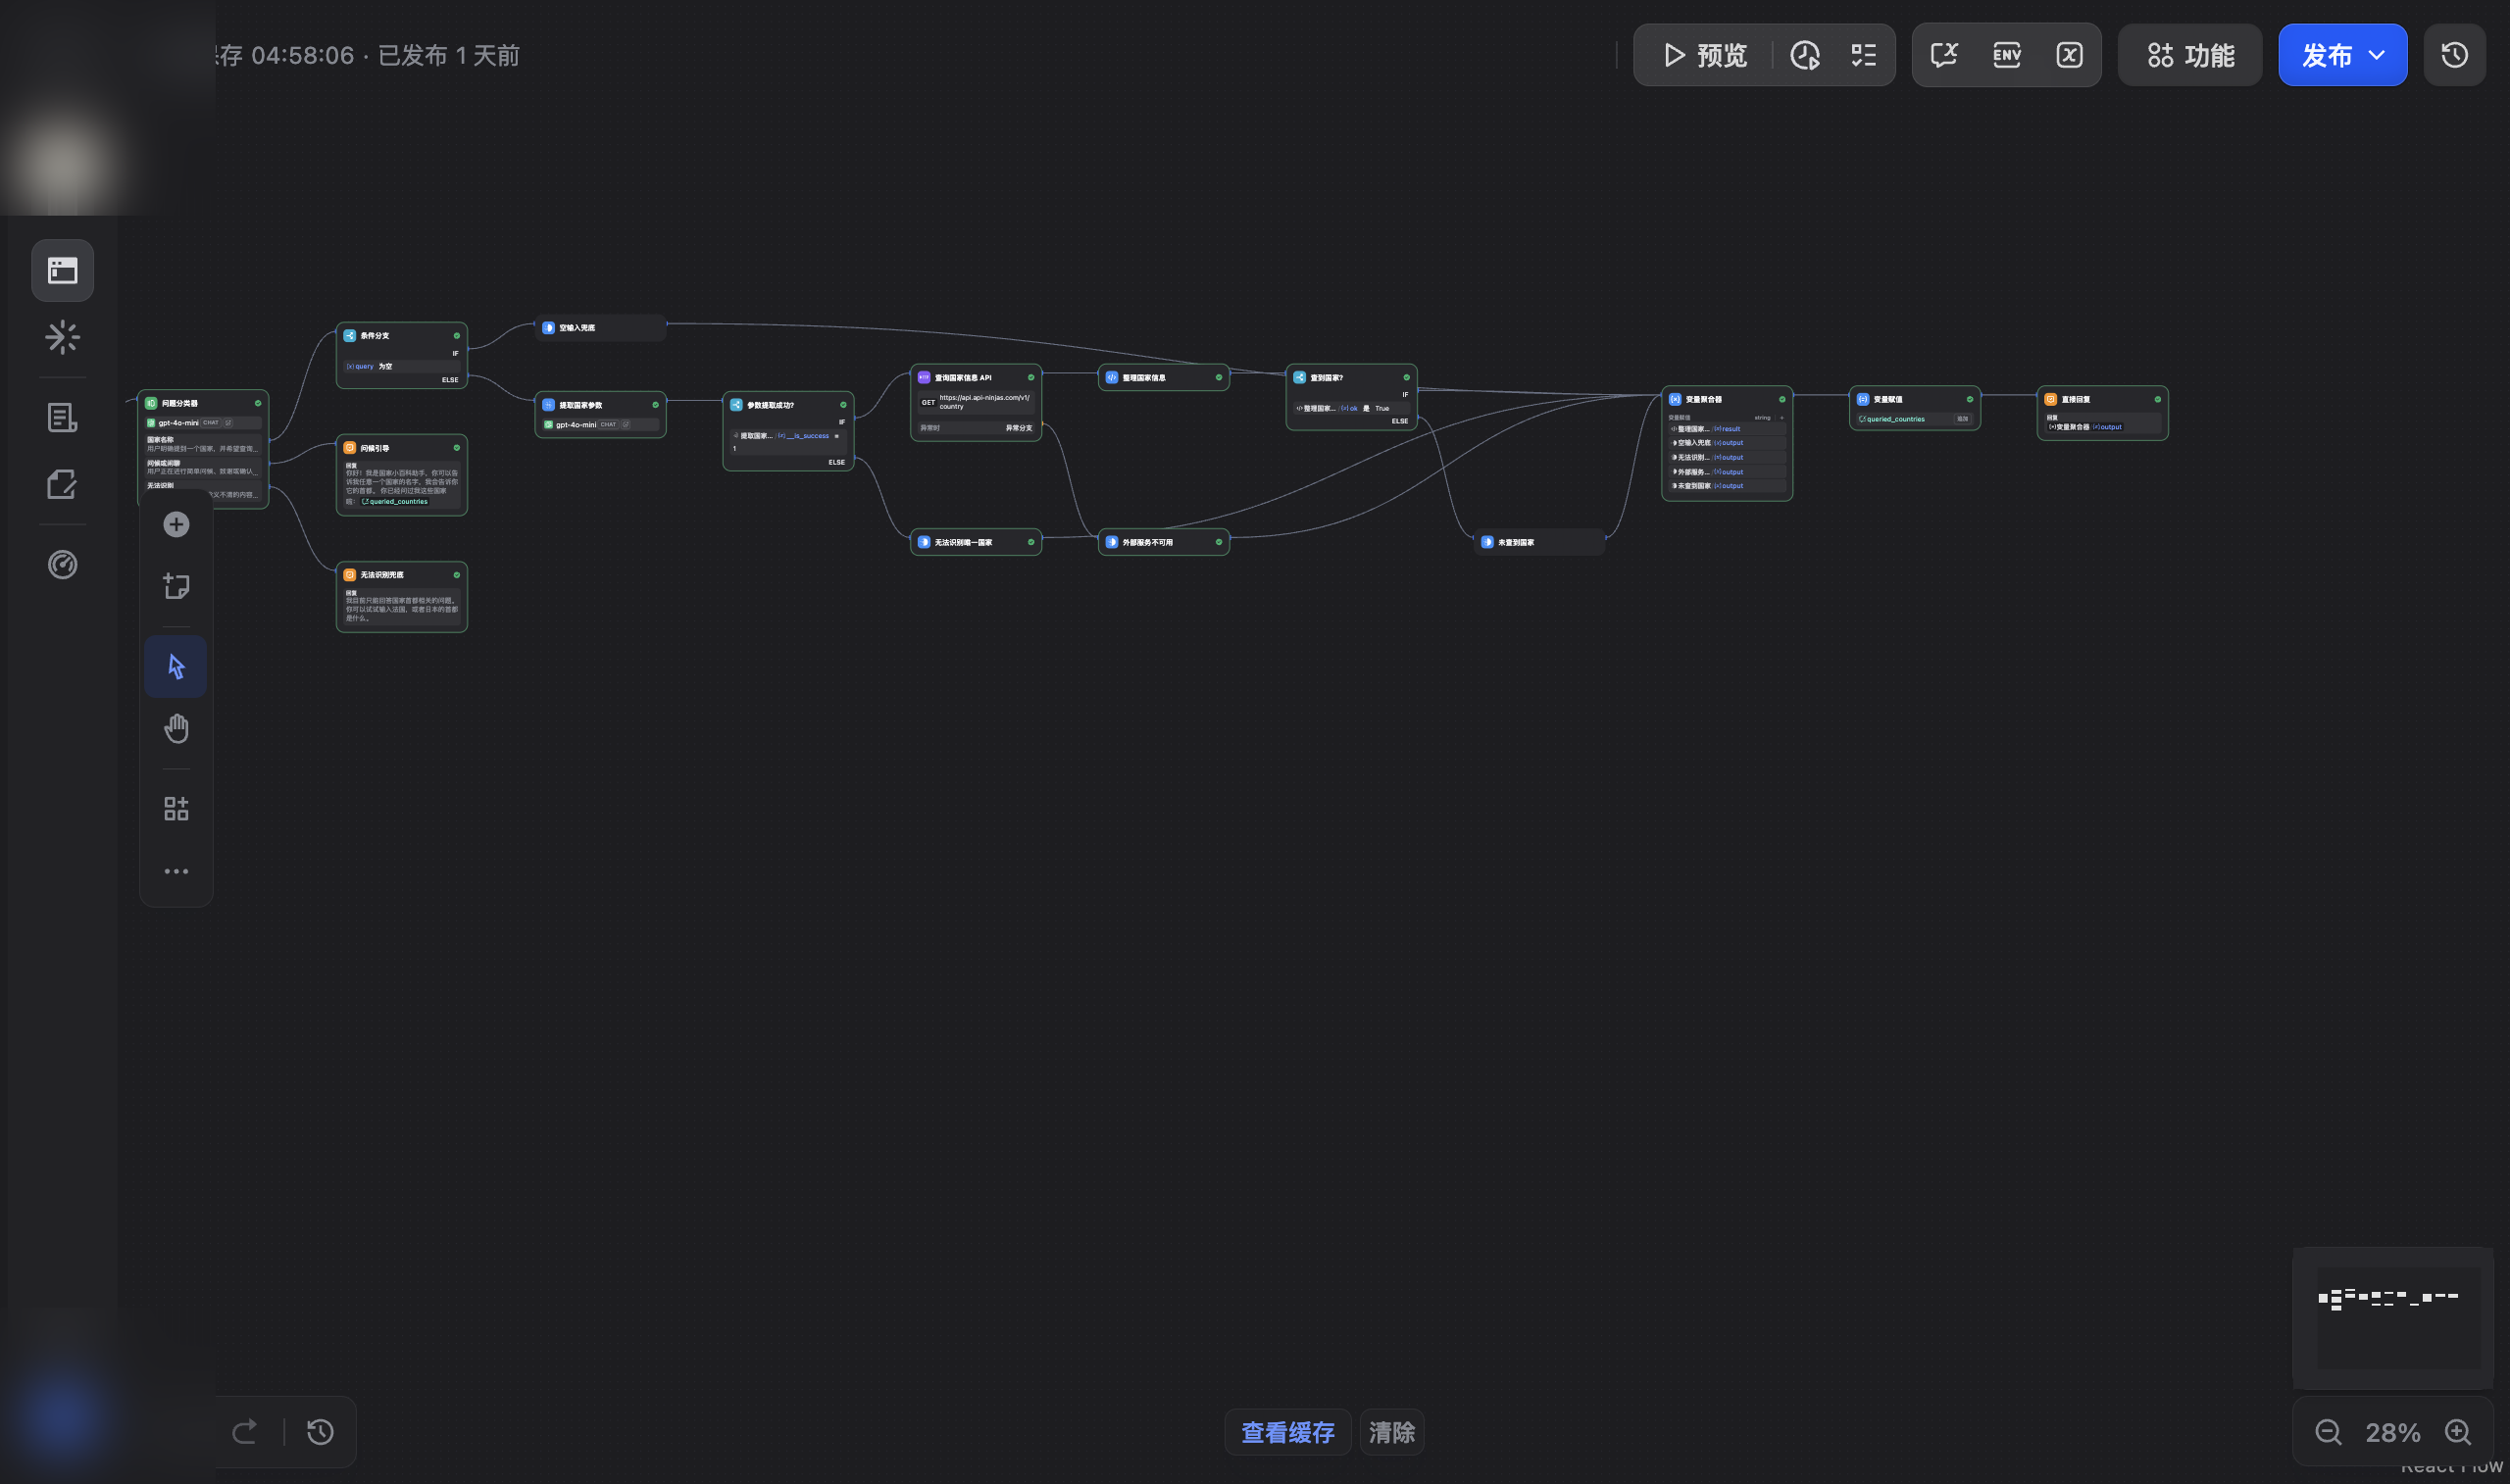
先把 Key 放进环境变量
在应用的环境变量中新增:
| 配置项 | 值 |
|---|---|
| 名称 | API_NINJAS_KEY |
| 类型 | Secret |
| 值 | 从 API Ninjas 账户复制的真实 Key |
选择 Secret 类型以后,Dify 会在工作流运行日志以及 HTTP Request 节点的请求日志中遮蔽这个值。这能降低调试和共享画布时意外暴露凭证的风险。
环境变量也让凭证与节点配置分开。Key 轮换时只改一处;把 DSL 分享给别人时,对方填入自己的 Key,无需逐个打开 HTTP 节点查找硬编码字符串。
但 Secret 变量不等于完整的密钥管理体系。谁能编辑应用、谁能修改环境变量、Key 是否设置了调用限制,仍然要由工作空间权限和 API 提供商侧的策略共同控制。最基本的一条纪律是:不要把真实 Key 写进 URL、代码块、节点名称或文章截图。
参数提取器:把一句话变成可调用的参数
用户很少会严格输入 API 要求的英文国家名。
他可能输入"日本",也可能输入"日本的人口和面积是多少?";同一个国家还可能写成中文、英文、简称或 ISO 代码。把整句 sys.query 原样拼进 name 参数,会让 API 接收到一段自己无法理解的自然语言。
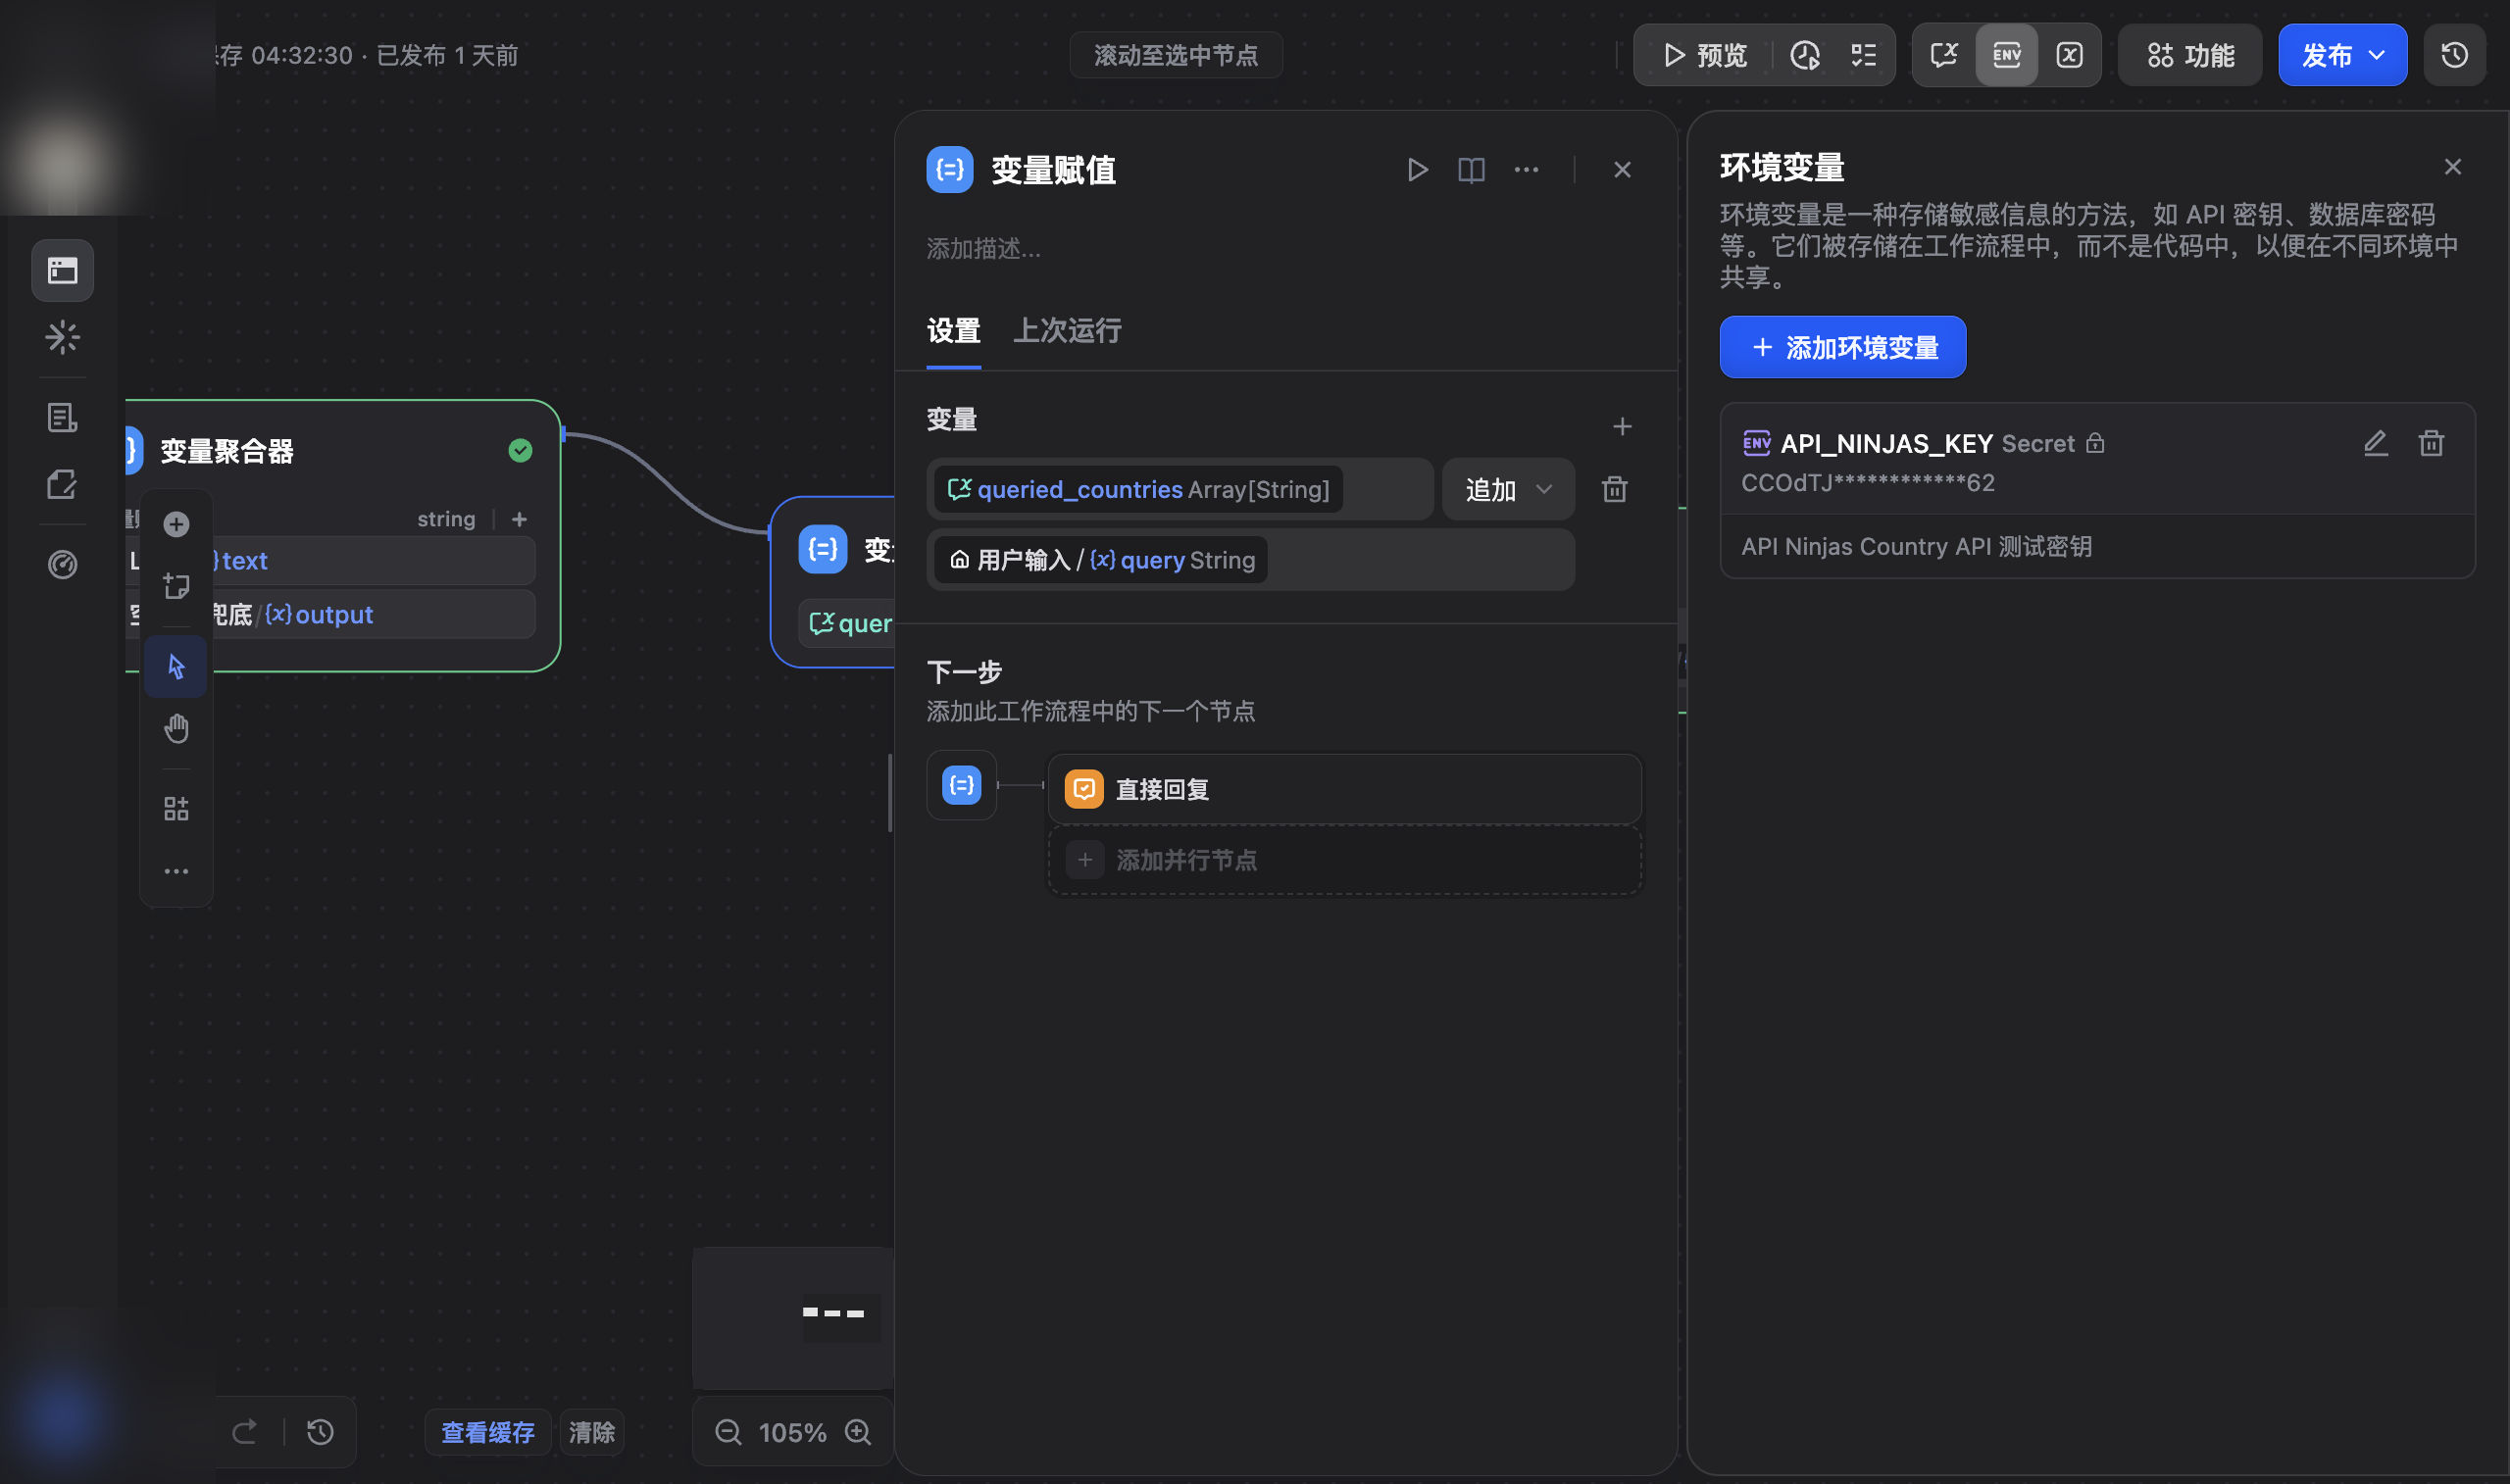
参数提取器解决的是这一段接口错位。Dify 官方把它定义为一种使用 LLM 将非结构化文本转换成结构化数据的节点。它要配置输入变量、模型、待提取参数及其类型和描述,还可以编写额外的提取指令。支持结构化输出的模型可以使用 Function Call/Tool Call 模式,其他场景可以使用基于提示词的提取模式。
在本例中,把输入变量设为 sys.query,定义两个必填字符串:
| 参数名 | 类型 | 必填 | 描述 |
|---|---|---|---|
country_name_en |
String | 是 | 供 API 查询的标准英文国家名;也可以输出 ISO 3166 alpha-2 代码 |
country_name_zh |
String | 是 | 供最终回复展示的常用中文国家名 |
提取指令可以写成:
从用户输入中提取唯一、明确的国家。
country_name_en 输出该国标准英文名;若英文名存在歧义,可输出 ISO 3166 alpha-2 代码。
country_name_zh 输出该国常用中文名。
不要把城市、地区、组织名称猜成国家。
若没有国家,或名称存在无法消除的歧义,不要臆测。
参数描述决定了模型究竟在提取什么。只写"国家"过于宽泛,遇到"刚果"时很容易直接选一个结果;把"唯一、明确"和歧义处理写清楚,才能让失败成为一条可设计的路径。
参数提取器还提供两个内置状态变量:__is_success 表示本次提取是否成功,__reason 提供失败原因。可以在它后面接一个 If/Else:成功才进入 HTTP Request;失败则走模板转换节点,输出一条稳定的引导文案:
我没有识别出唯一的国家名称。请换一种更明确的说法,例如"法国"或"刚果民主共和国"。
这里不把 __reason 原样暴露给用户。它更适合留在调试日志中;面向用户的失败消息应该说明下一步怎么改输入。
HTTP Request:让工作流按协议去取数据
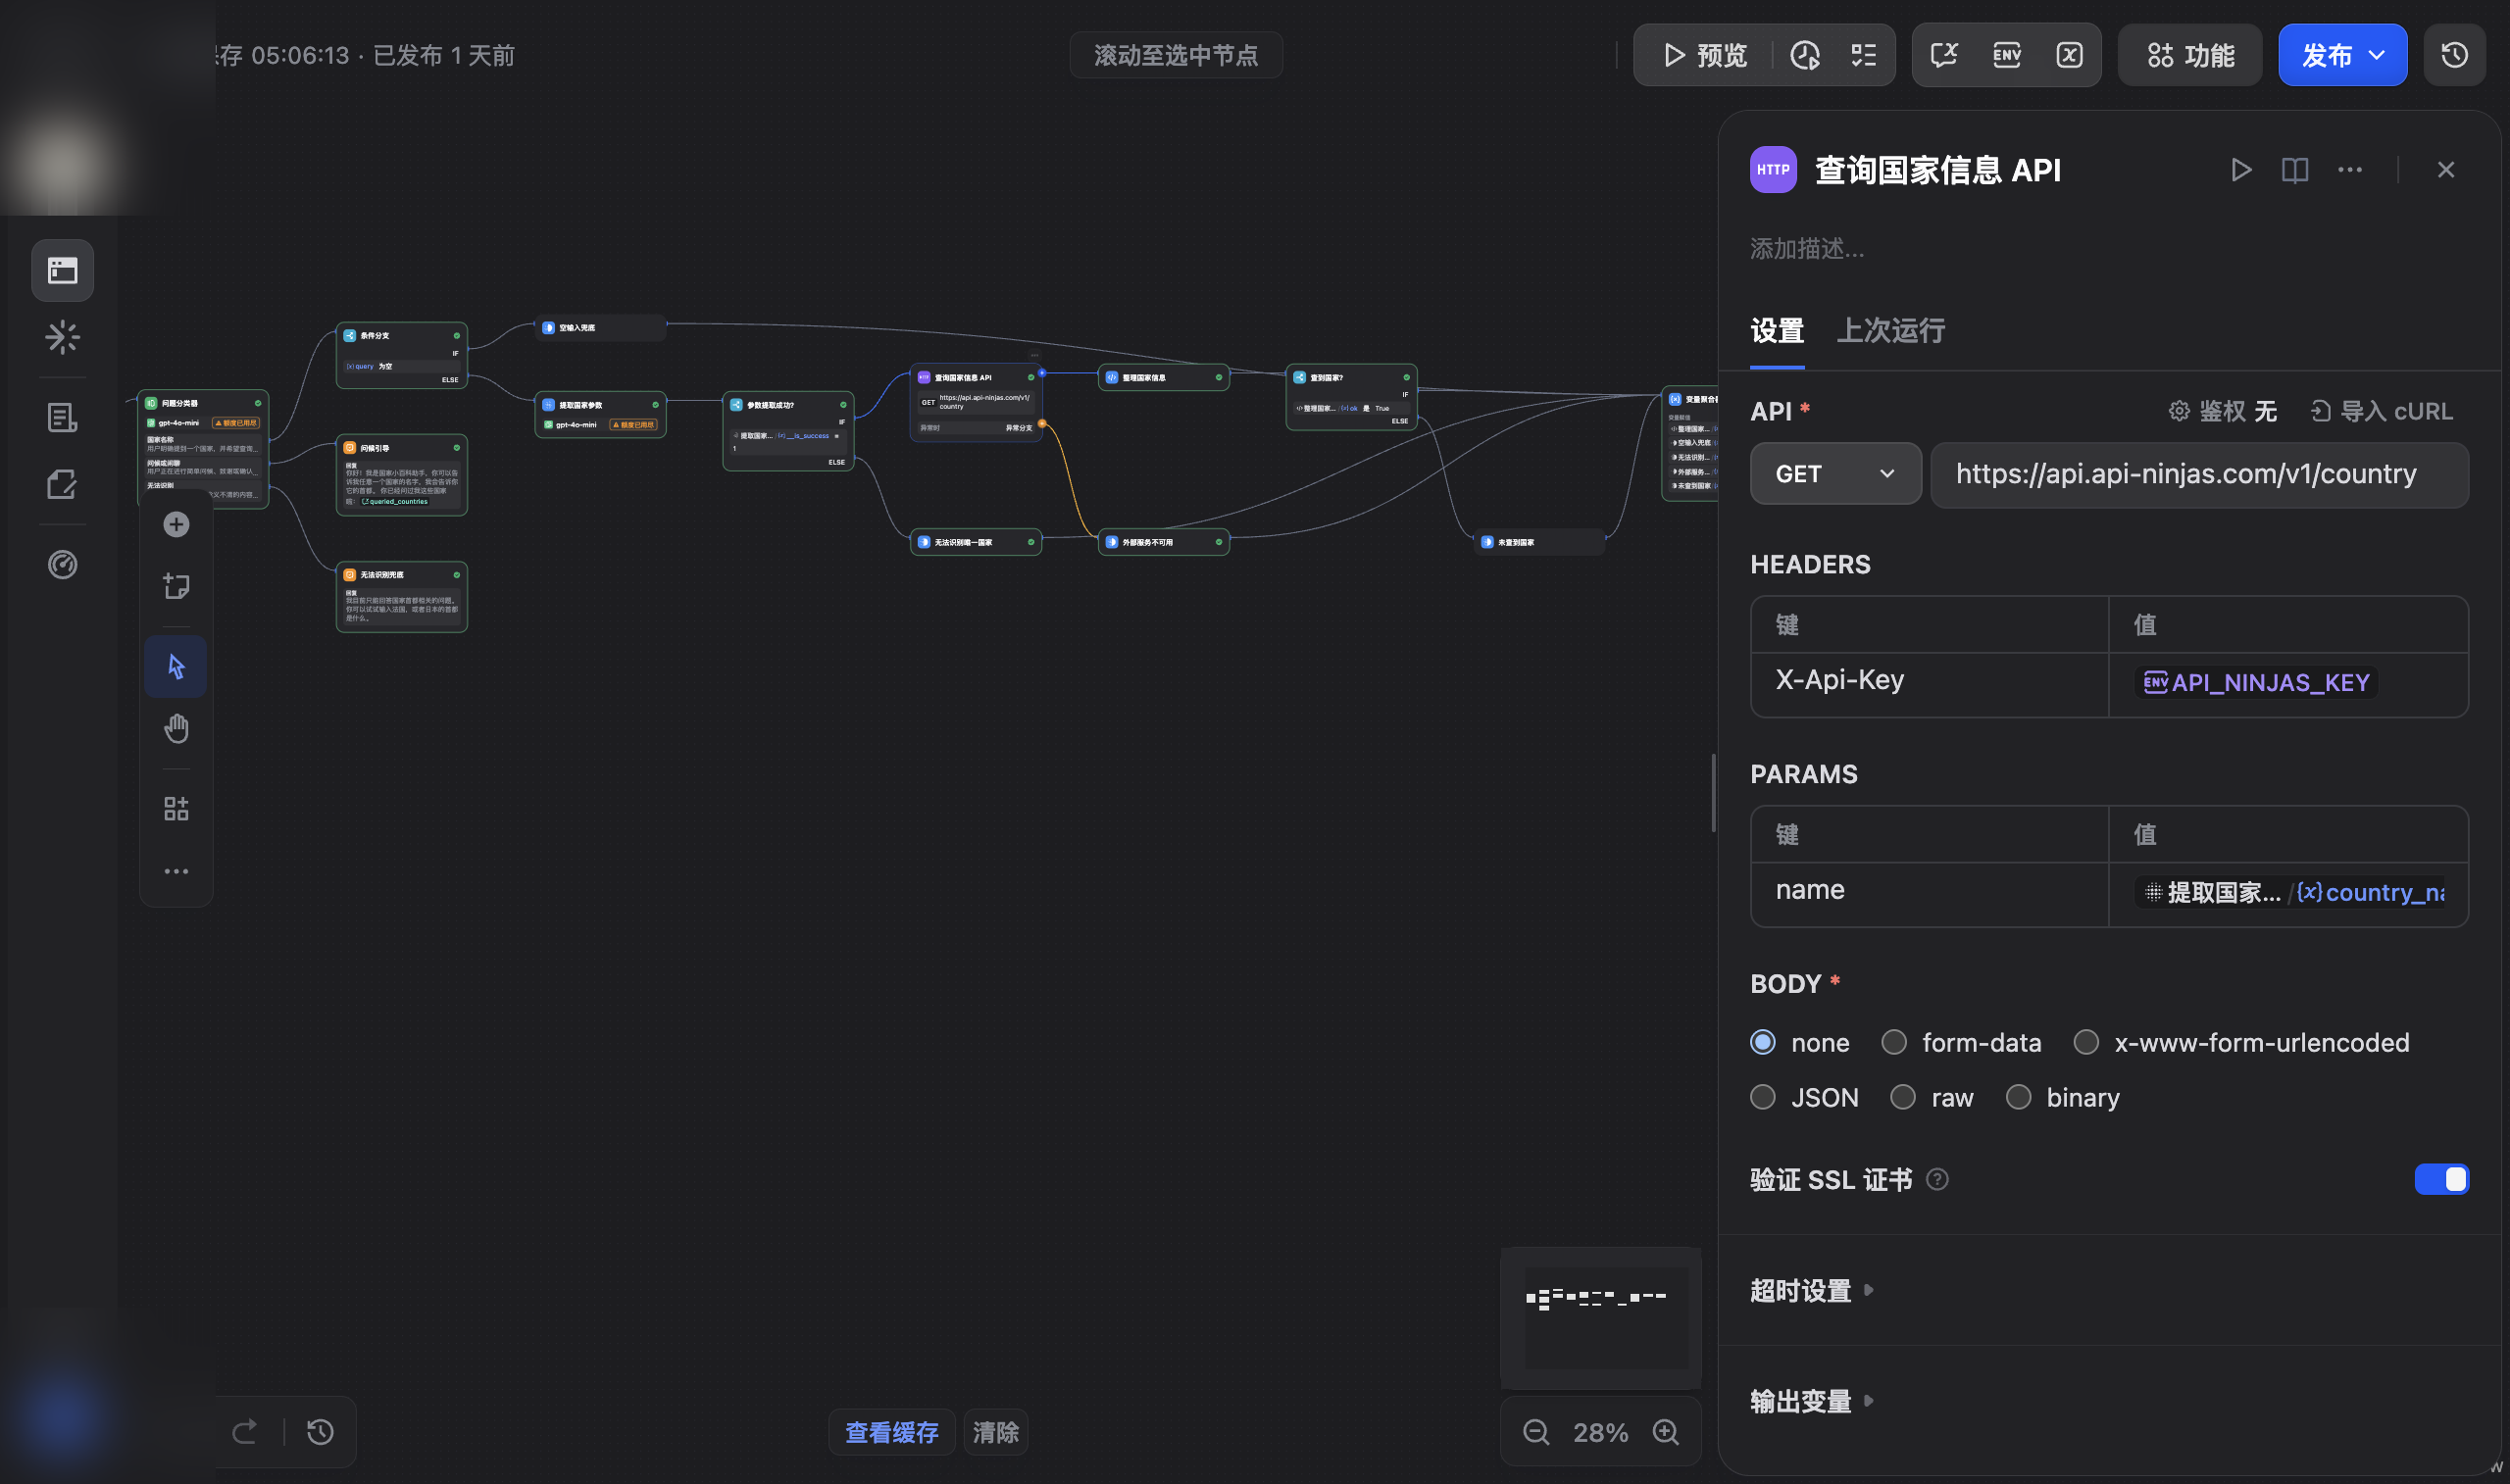
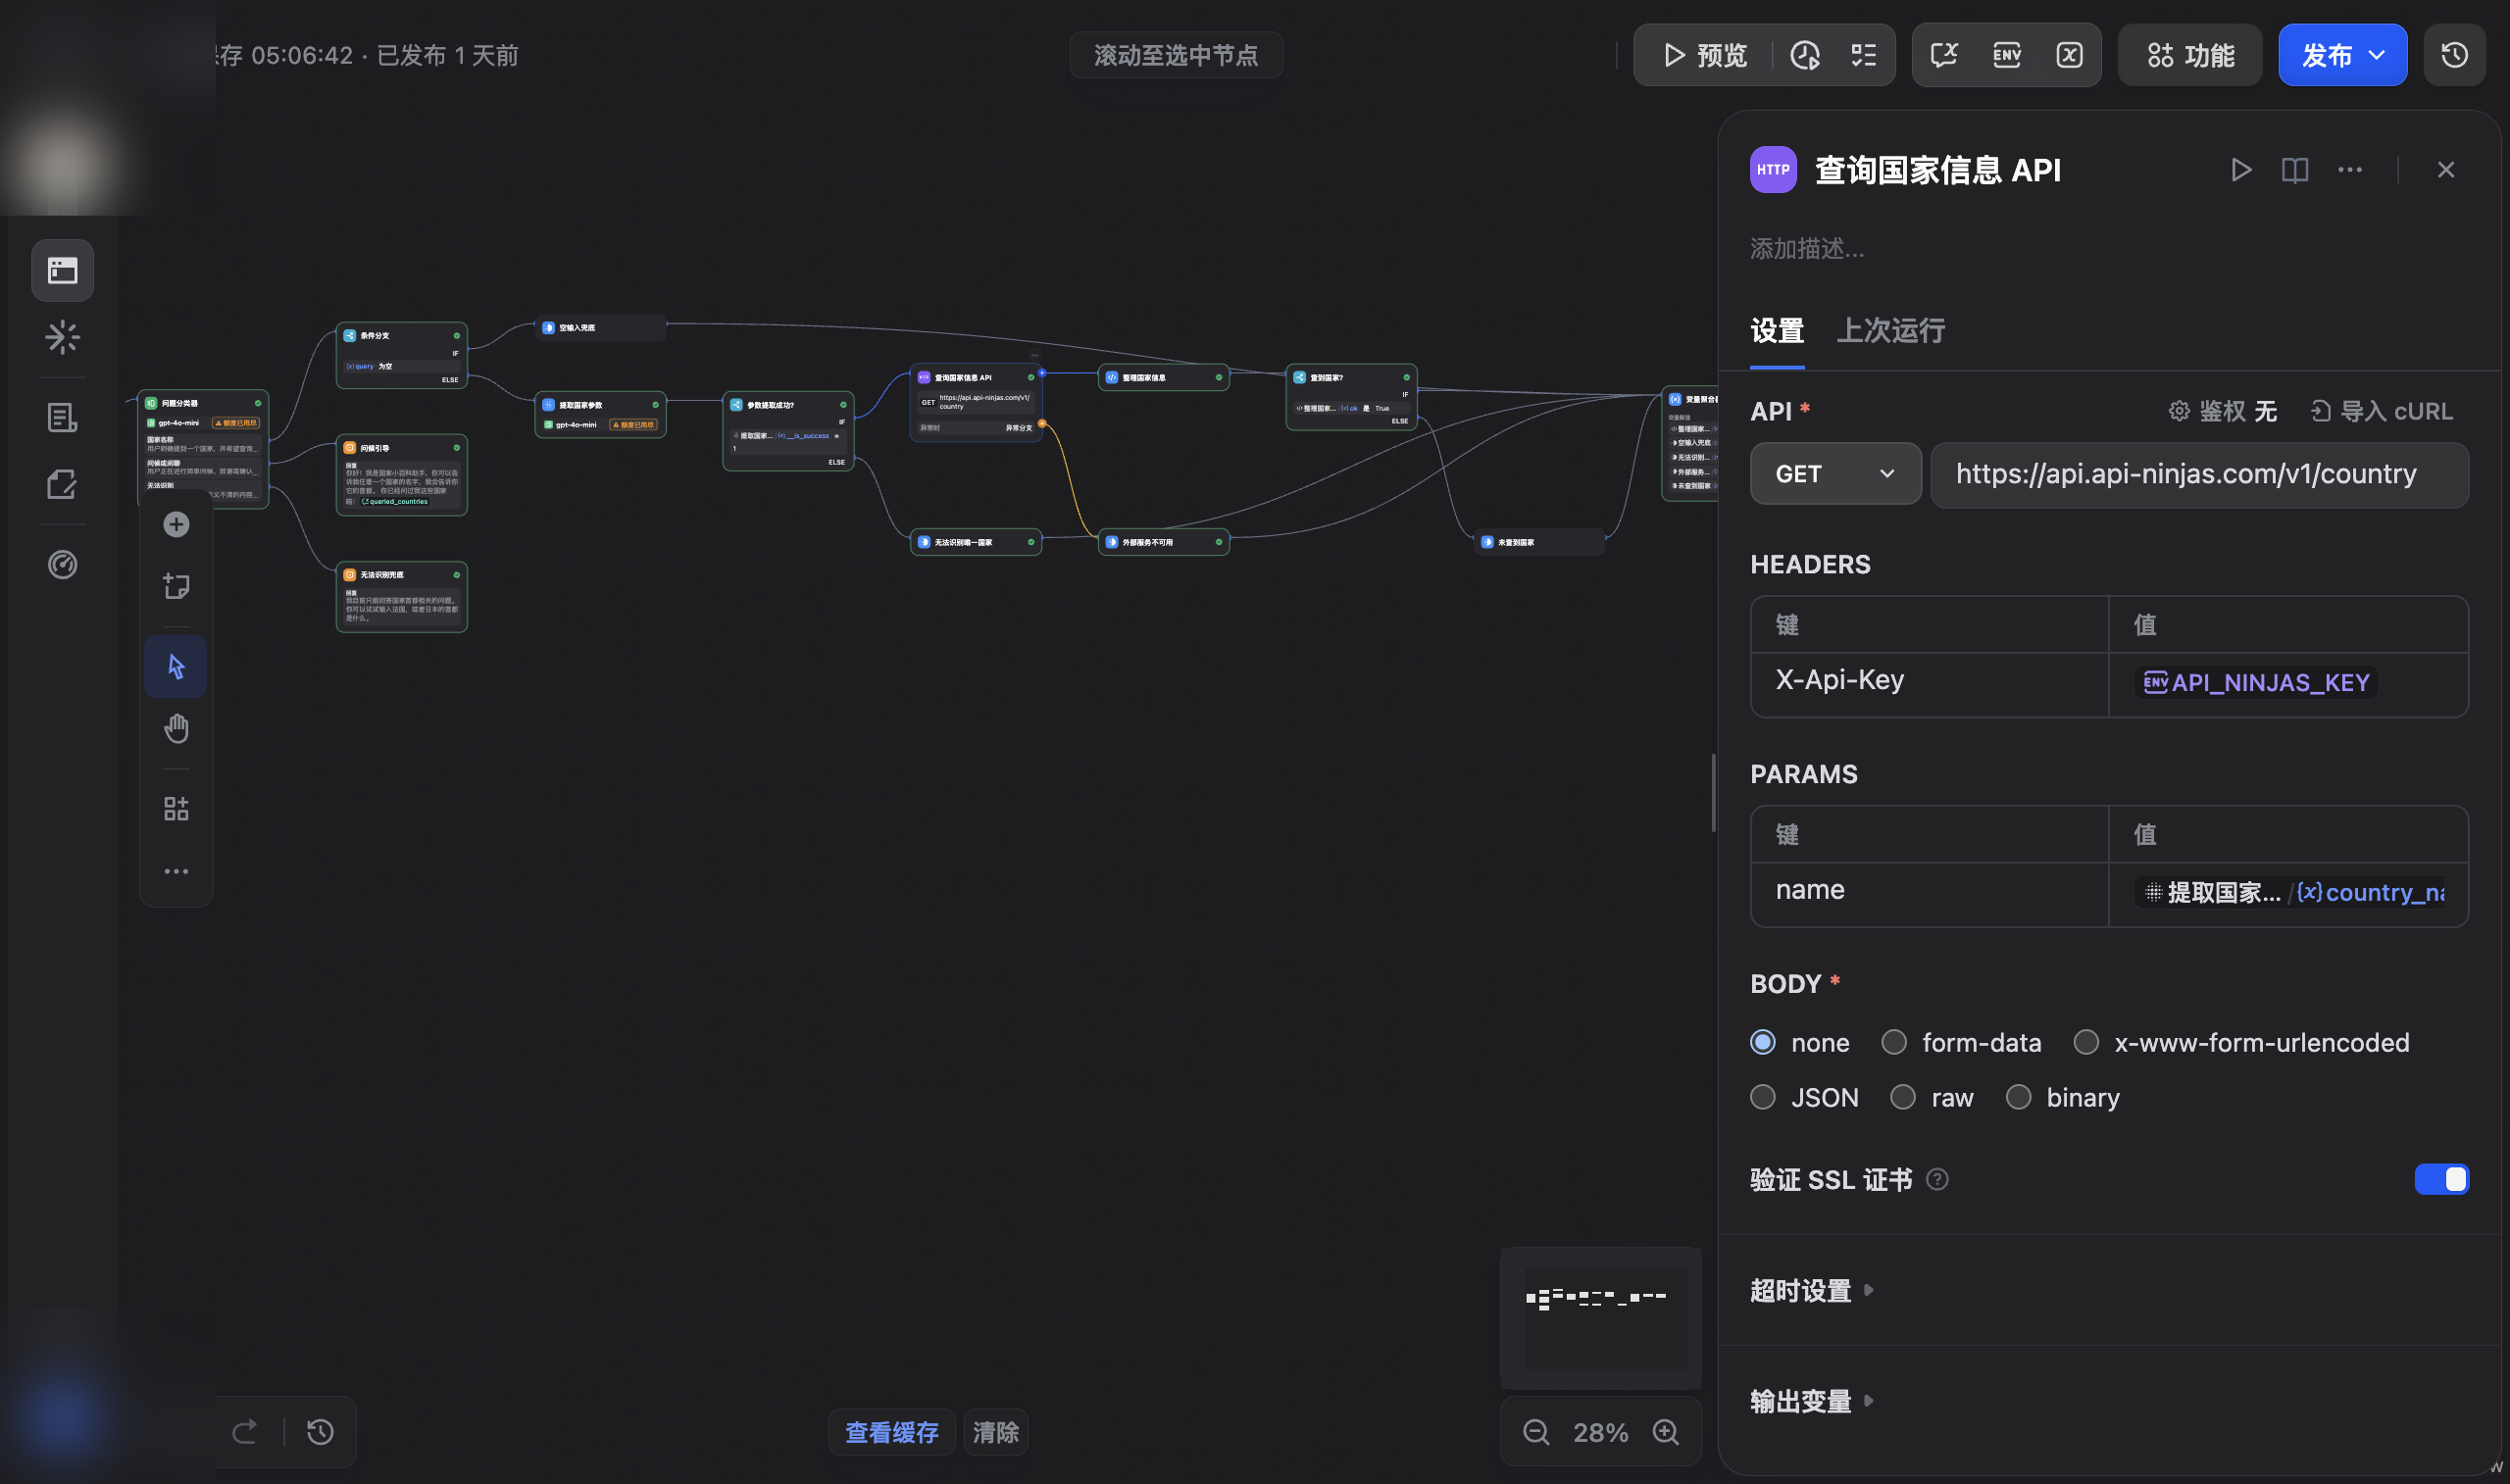
HTTP Request 节点负责连接外部 API、Webhook 和其他接受 HTTP 请求的服务。根据 Dify 当前官方文档,它支持常见的 GET、HEAD、POST、PUT、PATCH、DELETE 方法,也能配置 URL、查询参数、Headers、鉴权方式、请求体以及连接、读取、写入超时。
本例的关键配置如下:
| 配置项 | 值 |
|---|---|
| Method | GET |
| URL | https://api.api-ninjas.com/v1/country |
| Query 参数 | name = 参数提取器的 country_name_en |
| Header | X-Api-Key = 环境变量 API_NINJAS_KEY |
| Body | 留空 |
优先把 name 放进 Query 参数配置区,不要手工拼接整条 URL。节点可以清晰展示参数名与变量来源,也能少处理一层空格和特殊字符的 URL 编码问题。
X-Api-Key 的值通过变量选择器插入 Secret 环境变量。编辑器最终可能把变量显示成一个引用标签,也可能在导出的配置中呈现为模板语法;操作时以变量选择器生成的引用为准,不要照着文章手敲一段看似相同的花括号文本。
Dify 会把 HTTP 响应拆成下游可用的结构化输出,包括响应体、状态码、响应头、文件和大小信息。本例后续主要使用 body,调试时同时检查状态码:拿到一段 JSON 文本,只说明服务给了响应,还不能证明业务上查到了国家。
HTTP 失败不能交给下一节点猜
外部调用让工作流获得了新能力,也引入了新的不确定性。网络连接可能超时,API 可能短暂不可用,Key 可能被撤销或额度耗尽。
Dify 的 HTTP Request 节点支持连接、读取、写入超时,并能配置自动重试与失败后的替代分支。官方当前给出的上限是最多重试 10 次,重试间隔最长 5,000 毫秒。这个上限说明平台具备什么能力,不代表每个请求都应该重试 10 次。
Country API 是一个只读 GET 查询,本例可以为临时网络问题设置少量重试,例如重试 2 次、间隔 1 秒。若仍然失败,让节点进入失败分支,由模板转换节点输出:
外部国家信息服务暂时不可用,请稍后再试。
Key 无效通常也会进入请求失败路径。此时对用户继续重试没有帮助,开发者需要在运行日志中查看状态码和错误信息,再检查 API_NINJAS_KEY、免费额度和账户状态。正文不把"Key 无效"直接写给普通用户,因为那是应用内部配置问题。
生产环境还应该根据接口语义决定是否重试。GET 查询通常可以安全重试;会创建订单或扣款的 POST 请求需要考虑幂等性,盲目重试可能重复产生业务动作。
Code 节点:把外部 JSON 变成稳定输出
HTTP 节点返回的 body 仍是一段面向程序的数据。直接回复整段 JSON,会把字段名、数组括号、空值和未经换算的数字全部推给用户。
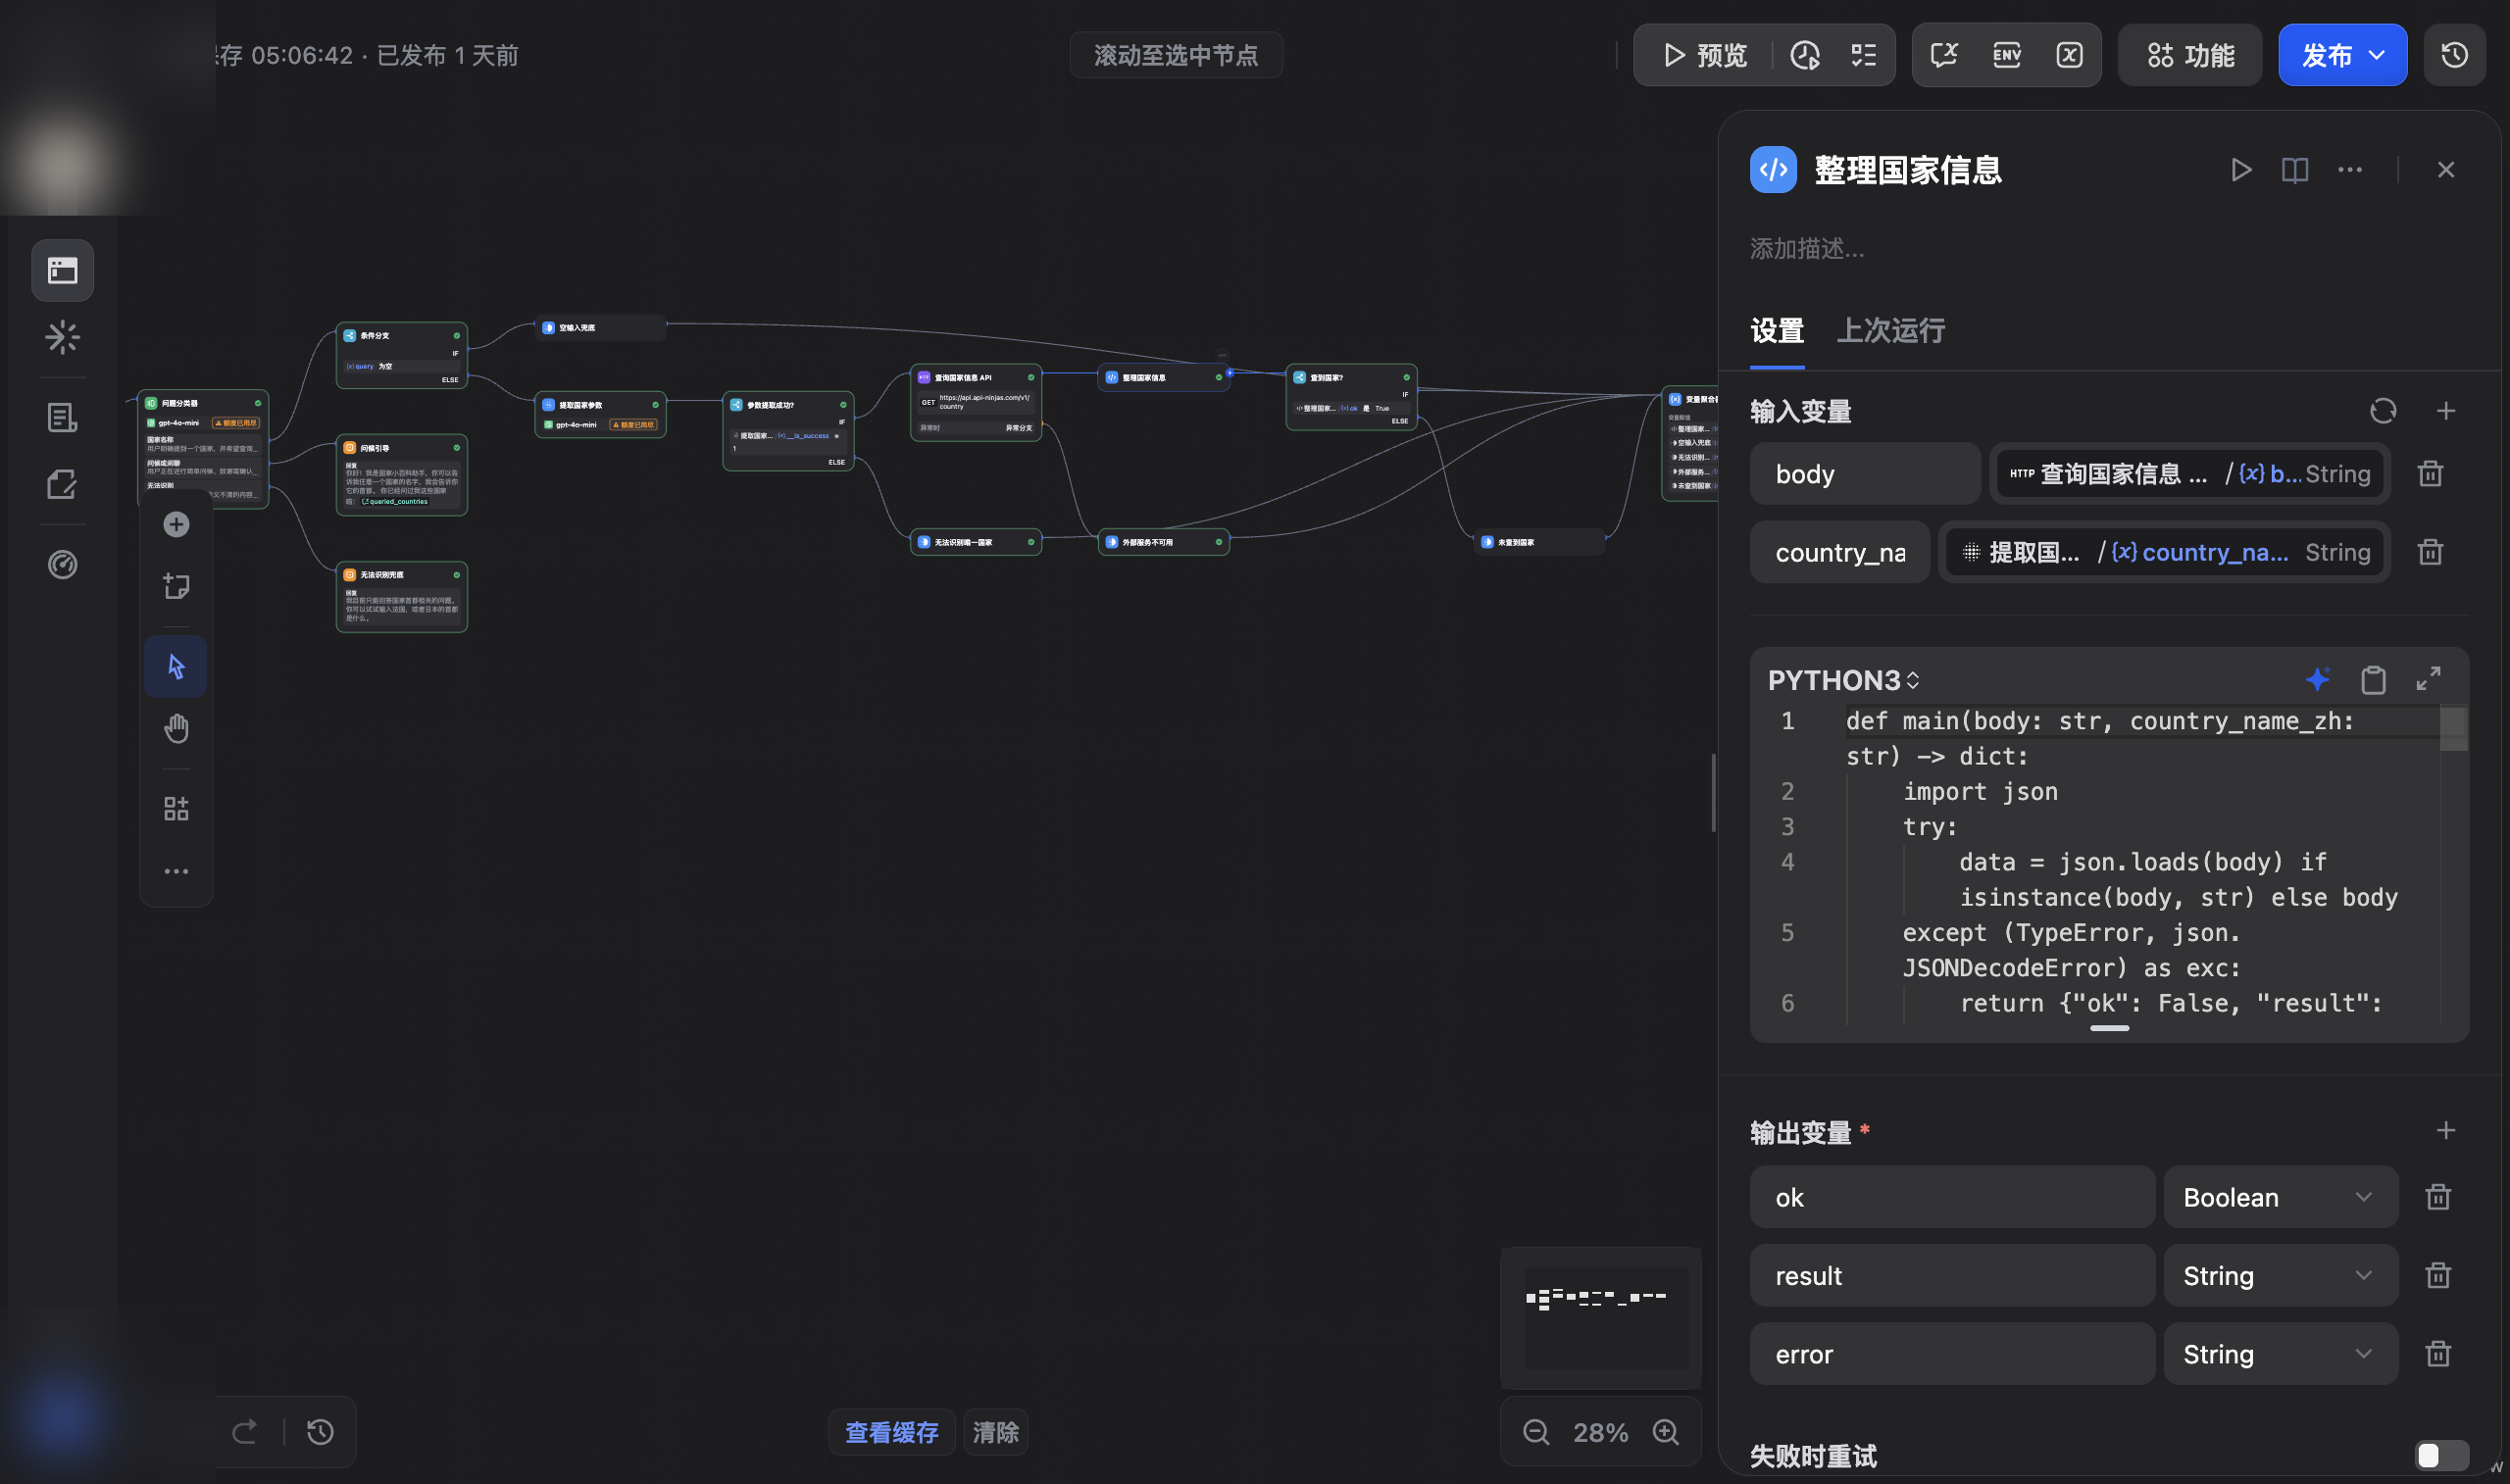
Code 节点适合承担确定性的数据转换。Dify 当前支持 Python 和 JavaScript:先声明输入变量,在代码中使用同名参数,函数返回一个字典,并为返回字段声明对应的输出变量。代码运行在隔离沙箱中,文件系统、系统命令和对外网络请求受到限制;访问 API 应继续交给 HTTP Request 节点,Code 只处理已经传入的数据。
为本例的 Code 节点声明两个输入:
body:HTTP Request 的响应体;country_name_zh:参数提取器输出的中文国家名。
再声明三个输出:
| 输出名 | 类型 | 用途 |
|---|---|---|
ok |
Boolean | 是否查到并成功整理国家数据 |
result |
String | 可以直接交给用户的正文 |
error |
String | 供调试或兜底判断使用的内部错误信息 |
Python 示例:
def main(body: str, country_name_zh: str) -> dict:
    import json

    try:
        data = json.loads(body) if isinstance(body, str) else body
    except (TypeError, json.JSONDecodeError) as exc:
        return {
            "ok": False,
            "result": "",
            "error": f"响应不是有效 JSON:{exc}",
        }

    if not isinstance(data, list) or not data:
        return {
            "ok": False,
            "result": "",
            "error": "接口返回空数组,没有匹配国家",
        }

    item = data[0]
    capital = item.get("capital") or "暂无数据"
    currency = item.get("currency") or {}
    currency_name = currency.get("name") or "暂无数据"
    currency_code = currency.get("code") or ""
    currency_text = (
        f"{currency_name}({currency_code})"
        if currency_code
        else currency_name
    )

    population_thousands = item.get("population")
    population_text = "暂无数据"
    if isinstance(population_thousands, (int, float)):
        population_text = f"{population_thousands * 1000:,.0f} 人"

    surface_area = item.get("surface_area")
    area_text = "暂无数据"
    if isinstance(surface_area, (int, float)):
        area_text = f"{surface_area:,.0f} 平方公里"

    result = "\n".join([
        f"{country_name_zh}的国家信息:",
        f"- 首都:{capital}",
        f"- 货币:{currency_text}",
        f"- 人口:{population_text}",
        f"- 国土面积:{area_text}",
        "",
        "数据来自 API Ninjas Country API;统计口径和更新时间以接口说明为准。",
    ])

    return {"ok": True, "result": result, "error": ""}
这段代码没有追求炫技。它只做四件可以复核的事:解析 JSON、确认数组非空、读取固定字段、格式化文本。字段缺失时显示"暂无数据",整条记录缺失时返回 ok = False。
这样的工作适合 Code,因为规则明确、同样输入应该得到同样输出。若把格式化也交给 LLM,模型会增加一次调用成本,还可能改写数字或漏掉字段。需要语言润色时当然可以再接模型,但原始事实和展示格式最好先在确定性节点里站稳。
参数提取器和 Code 都在处理数据,差别在哪里
这两个节点很容易被写成一组模糊的"数据清洗工具"。它们面对的问题其实不同。
| 节点 | 输入特征 | 处理方式 | 本例任务 |
|---|---|---|---|
| 参数提取器 | 自然语言、表达不稳定 | 借助 LLM 理解语义 | 从问题中识别标准国家名 |
| Code | JSON、字段与规则明确 | 执行确定性程序 | 解析响应、换算单位、拼接文本 |
判断该用哪一个,可以看规则能否完整写进普通代码。
"从‘日本的首都是什么’里识别日本"涉及语言理解、别名和上下文,参数提取器更合适。"把 population 乘以 1,000 并加千位分隔符"有唯一清晰的算法,Code 更合适。
参数提取器的结果也需要测试。它背后仍然是模型,可能受表达、模型能力和提取指令影响。Code 的输出更加确定,但前提是我们正确理解了 API 的字段和单位。两者都不能因为节点运行成功就跳过业务校验。
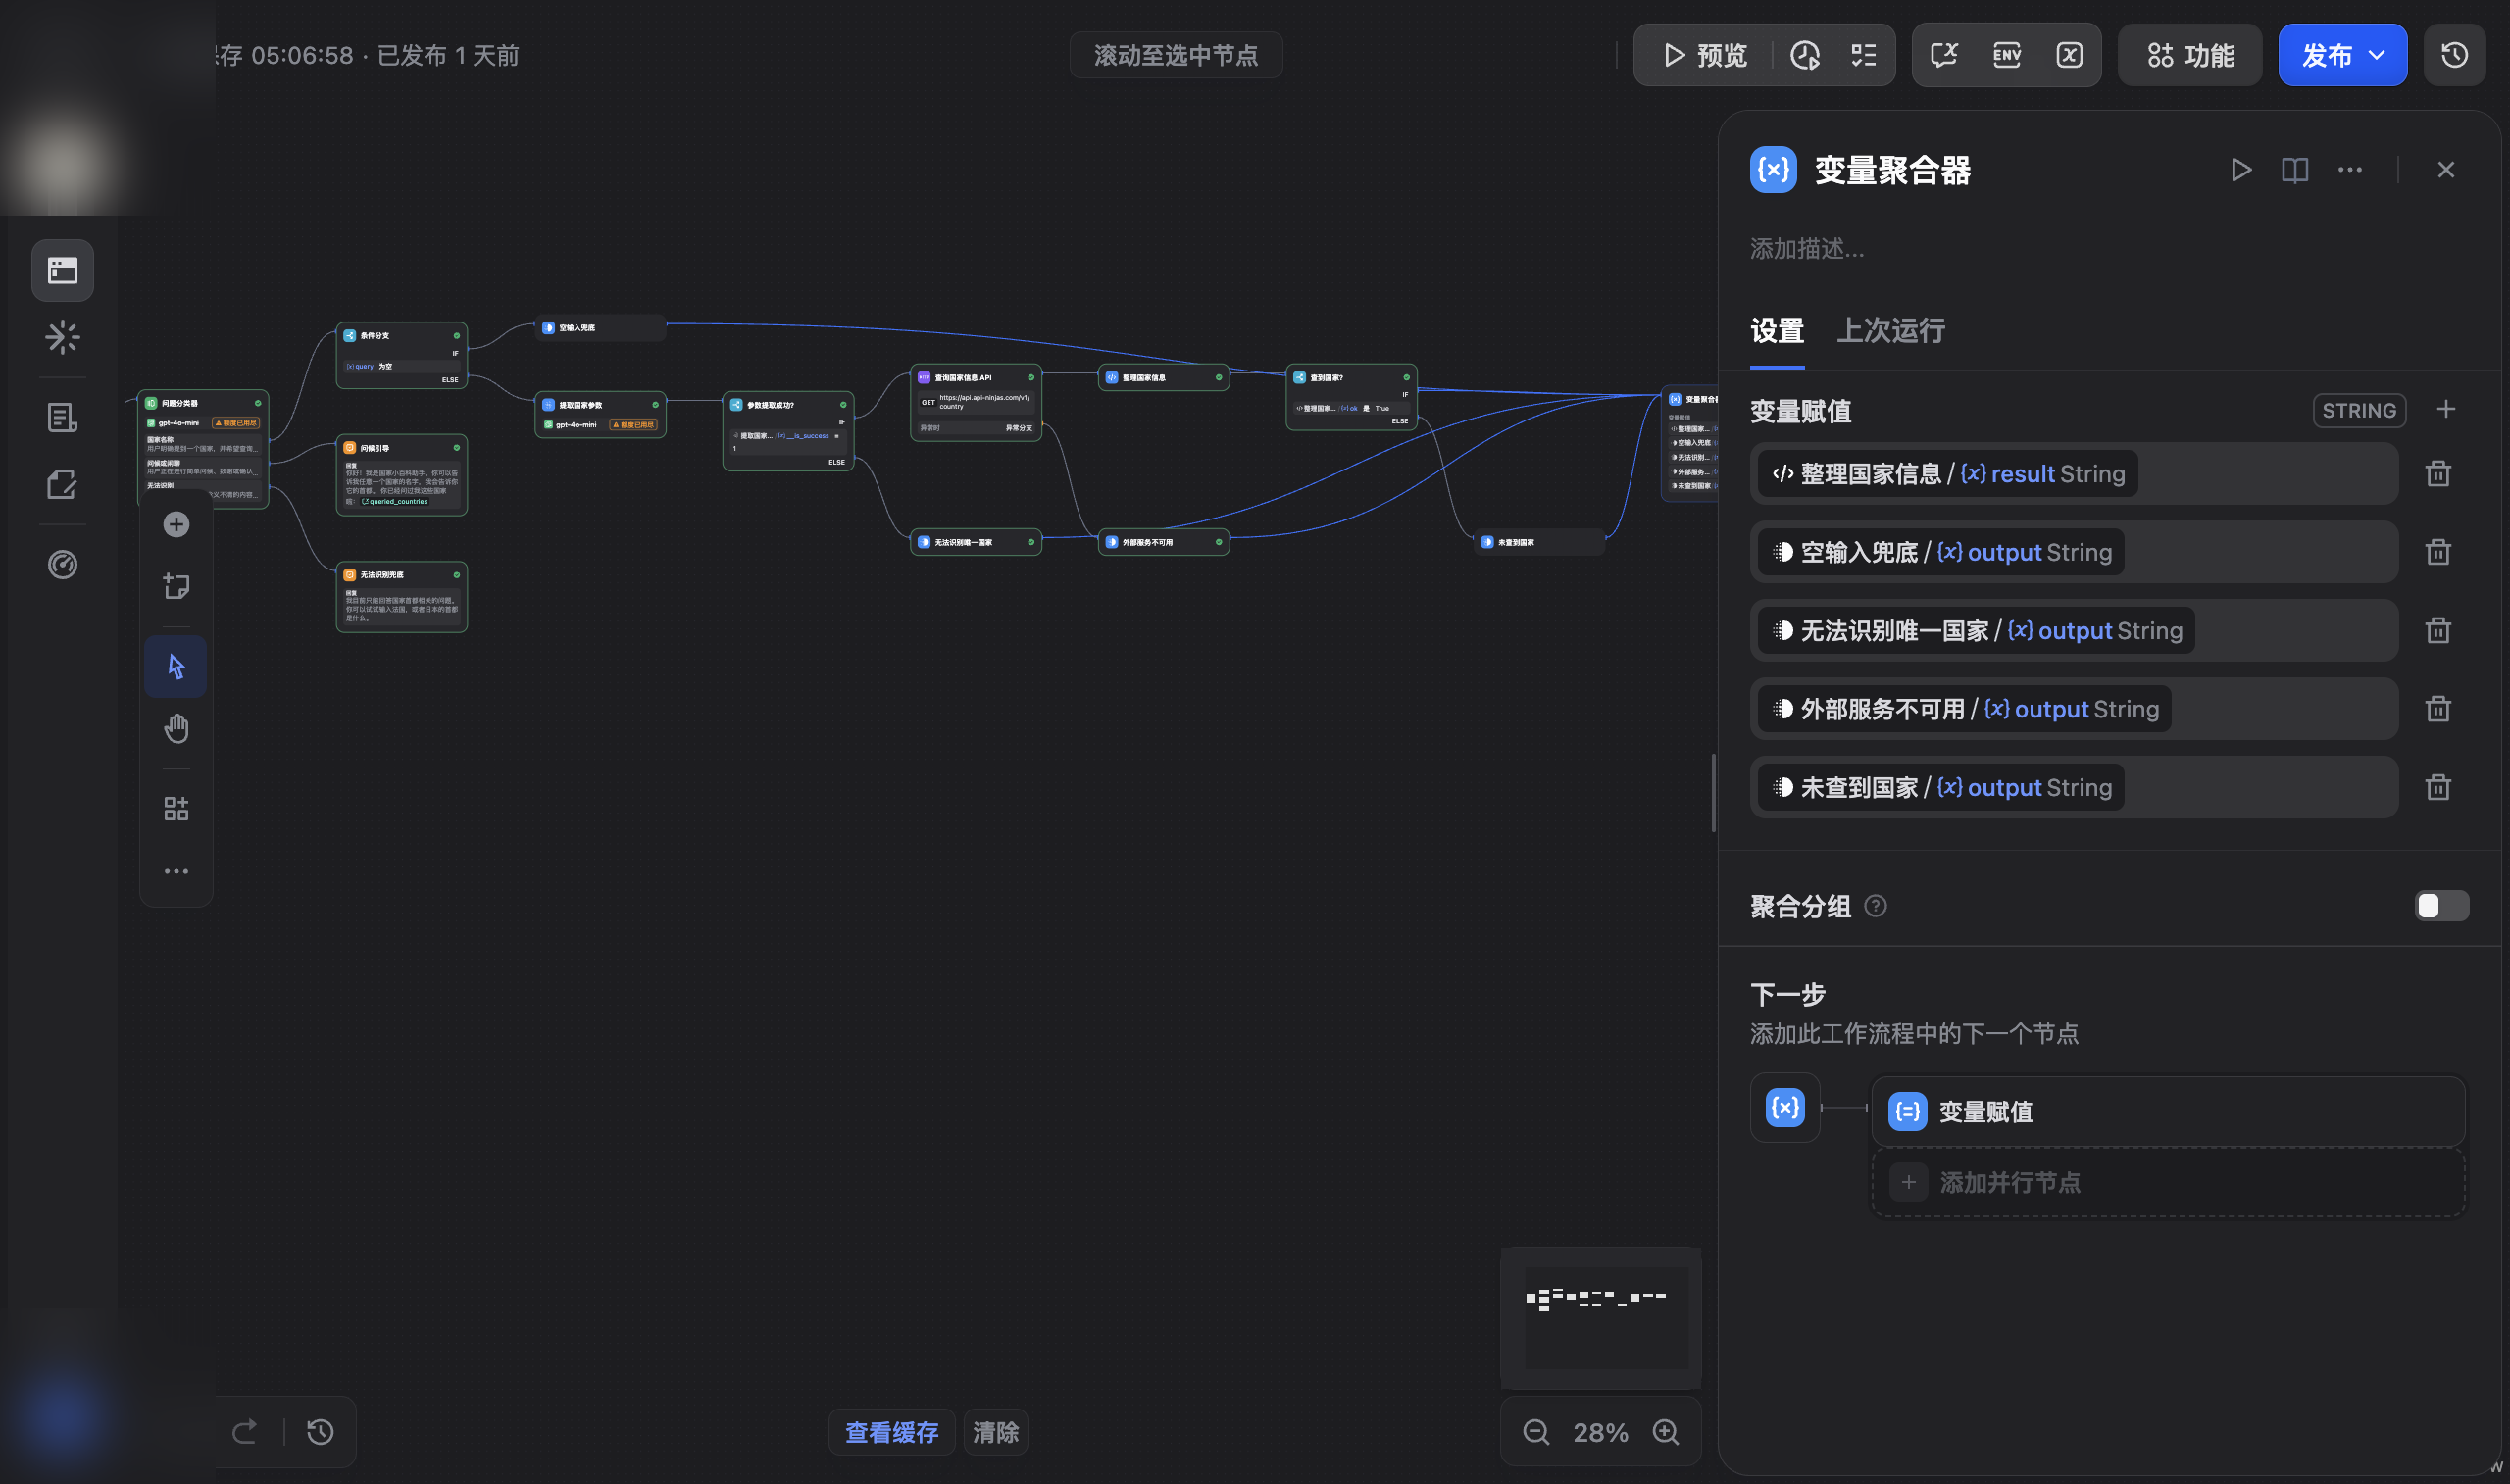
把成功结果和三种失败重新收进统一出口
Code 后面再接一个 If/Else,判断 ok 是否等于 true:
true:把result送入 EP4 已有的变量聚合器;false:进入"未查到国家"模板转换节点,再把模板输出送入同一个聚合器。
未查到国家时的文案可以是:
没有查到这个国家。请检查名称是否正确,或尝试输入标准国家名,例如"法国"。
加上前面的路径,这条分支现在有四种可能交付给聚合器的字符串:
- 原有空输入兜底;
- 参数提取失败兜底;
- HTTP 调用失败兜底;
- Code 的成功结果或查无结果兜底。
这些路径互斥,一次运行只会产生其中一个字符串,符合变量聚合器的使用边界。聚合器之后仍连接原有变量赋值器,把本轮 sys.query 追加到 queried_countries,再由唯一的直接回复节点输出。
这里有一个值得讨论的状态语义:失败查询要不要写进历史?沿用 EP4 的结构,这四类结果(其中 Code 分支又分成功回复和查无结果两种具体文案,合计五种具体文案)都会经过变量赋值器,因此失败输入也会进入查询历史。教学稿先保留这个行为,便于把改造范围锁定在外部调用链路。如果产品把 queried_countries 定义成"成功查到的国家",就应该把变量赋值器移到成功路径,或改为追加参数提取器输出的标准国家名。变量放在哪里,取决于你准备怎样解释这份历史。
一条成功路径,要从输入查到每个中间值
先在预览中输入:
日本的人口、首都和货币是什么?
不要只检查最后有没有出现"东京"。逐个打开节点运行结果,确认:
- 问题分类器进入"国家名称";
- 参数提取器输出
country_name_en = Japan、country_name_zh = 日本,并且__is_success = 1; - HTTP Request 发出
GET请求,Query 中的name是Japan,状态码成功,响应体是非空 JSON 数组; - Code 返回
ok = true,人口完成千人到人的换算,货币从嵌套对象中取出名称和代码; - 变量聚合器输出与 Code 的
result一致; - 变量赋值器追加本轮原始问题;
- 直接回复只展示一次最终结果。
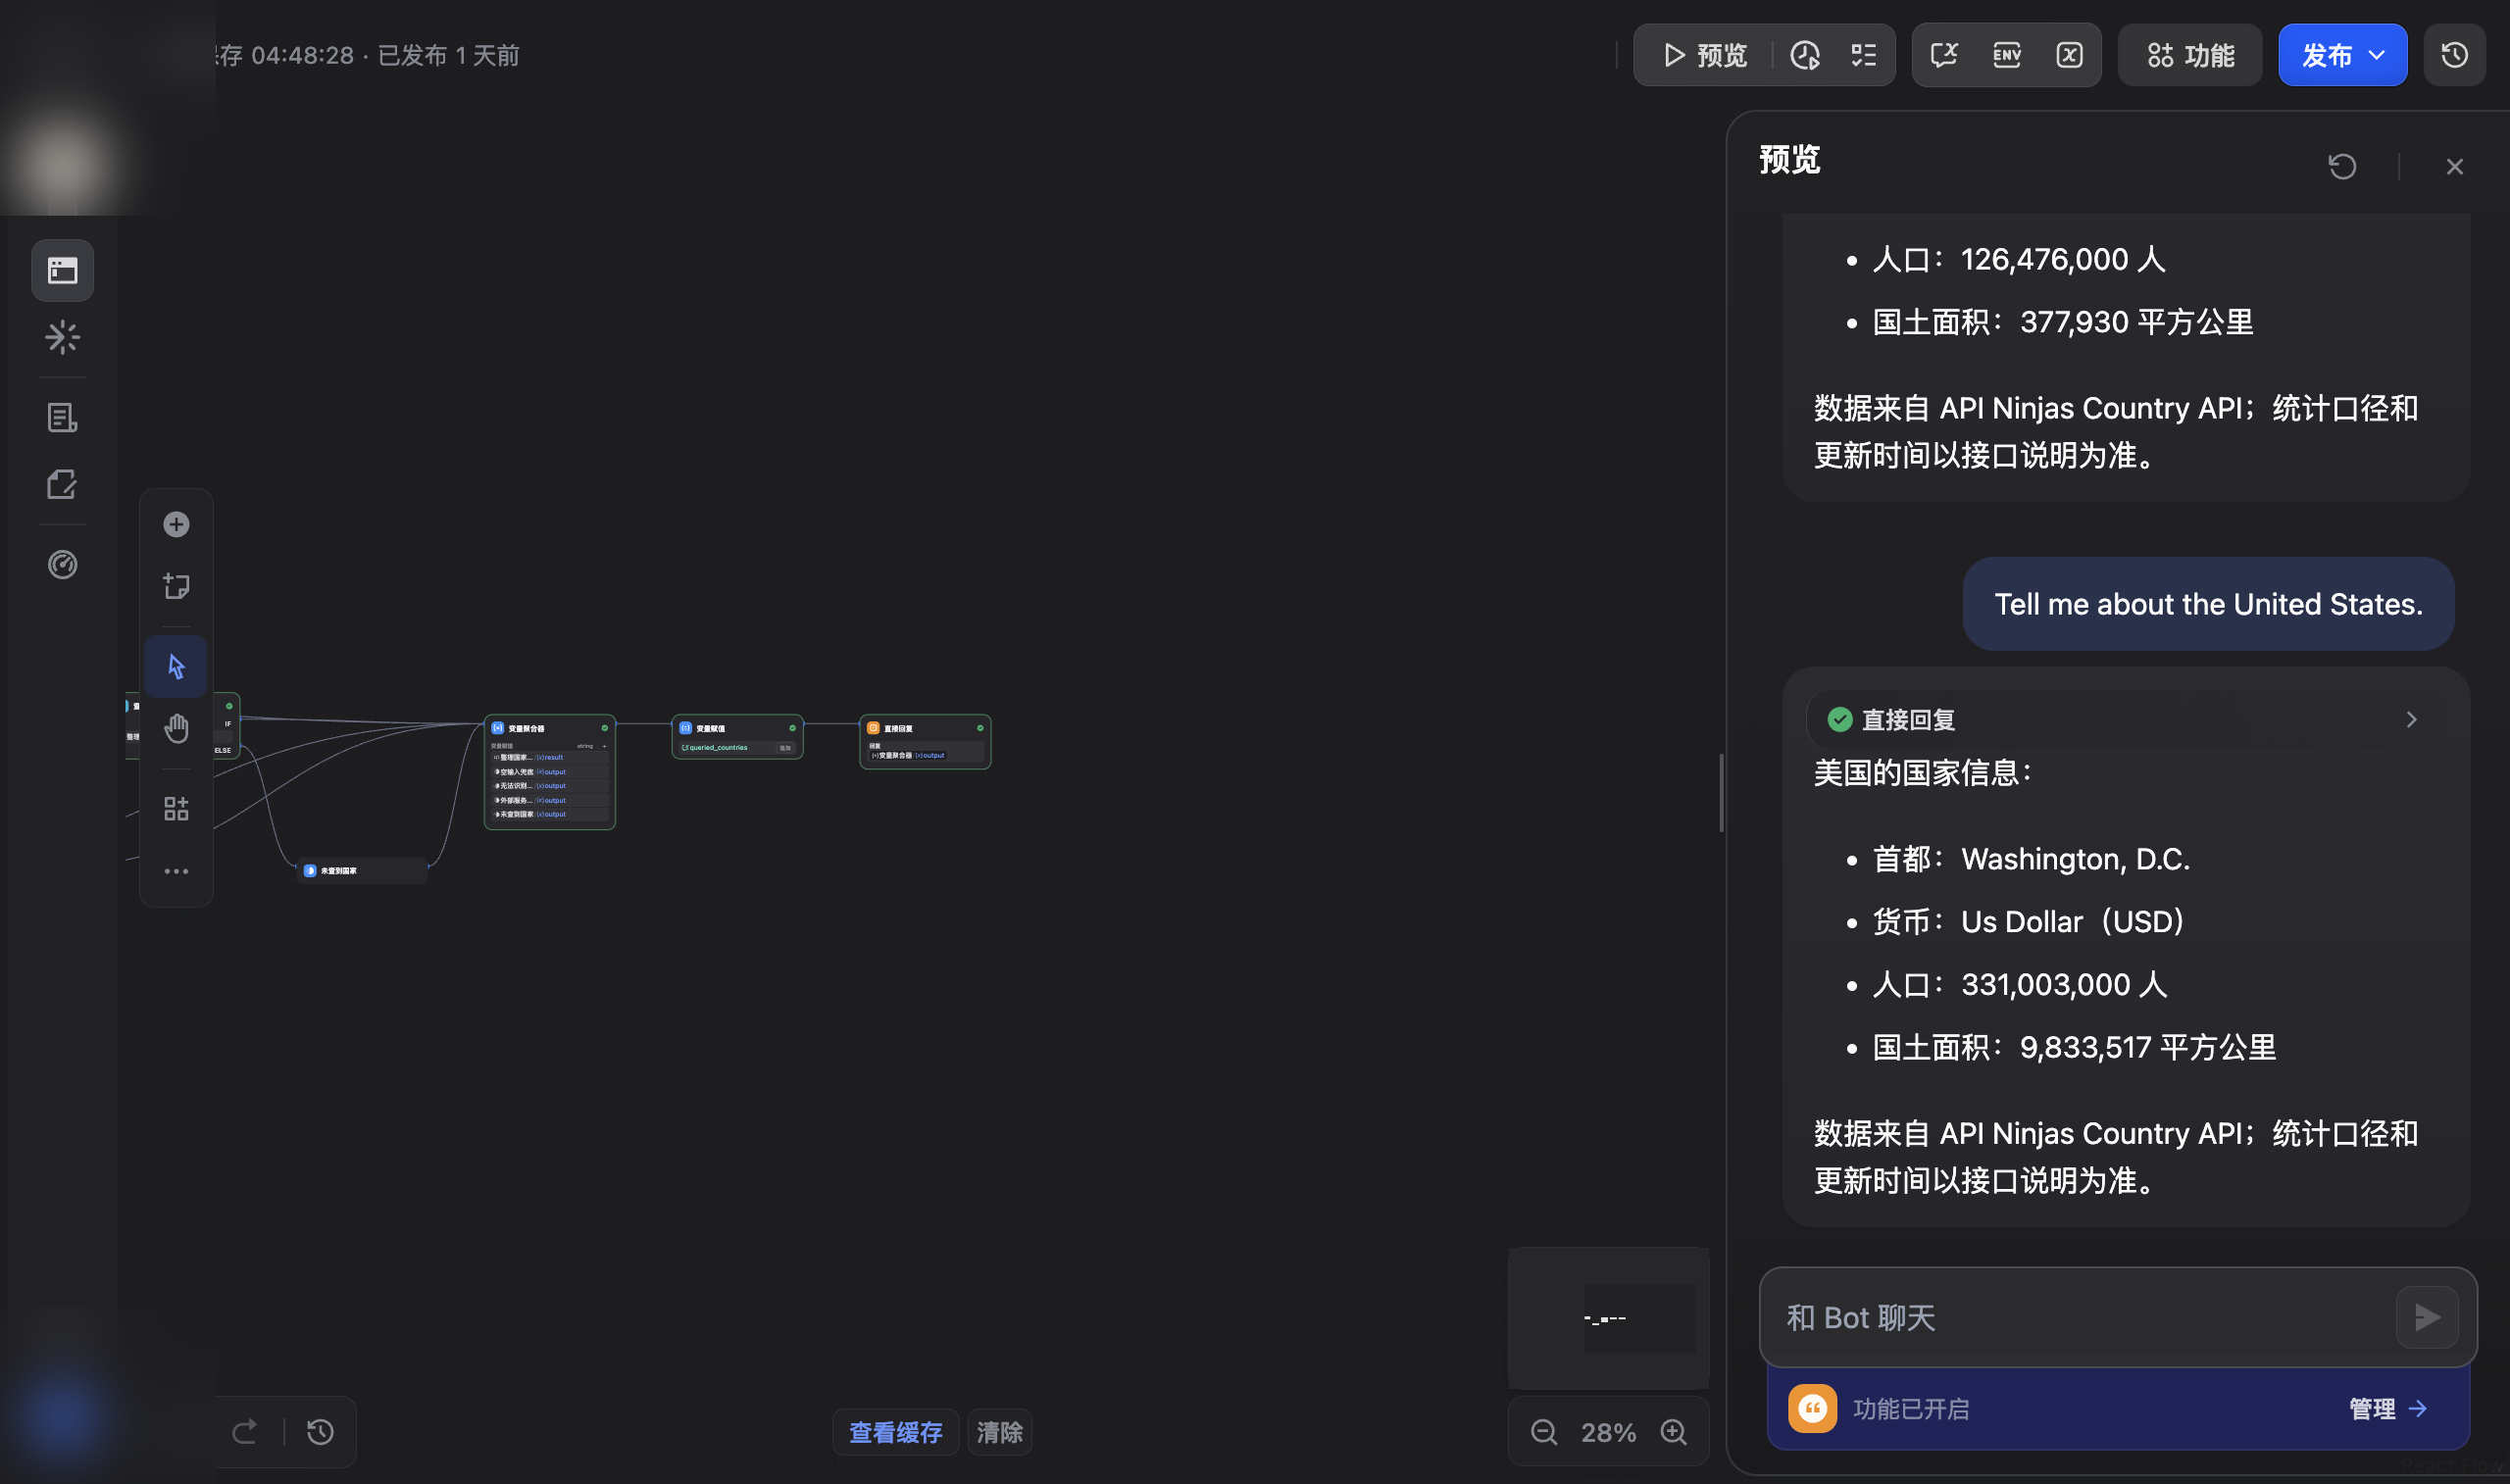
再测试一个带空格的英文国家名:
Tell me about the United States.
重点观察 Query 参数是否被正确编码,以及参数提取器有没有输出 API 可接受的 United States 或 US。这能验证我们把参数放进 Query 配置区的选择确实生效。
越界路径测试:外部世界不会永远配合
接入 API 后,"能跑通一次"只是测试的起点。至少要覆盖下面三组失败。
国家名不存在或有歧义
输入:
刚果的人口是多少?
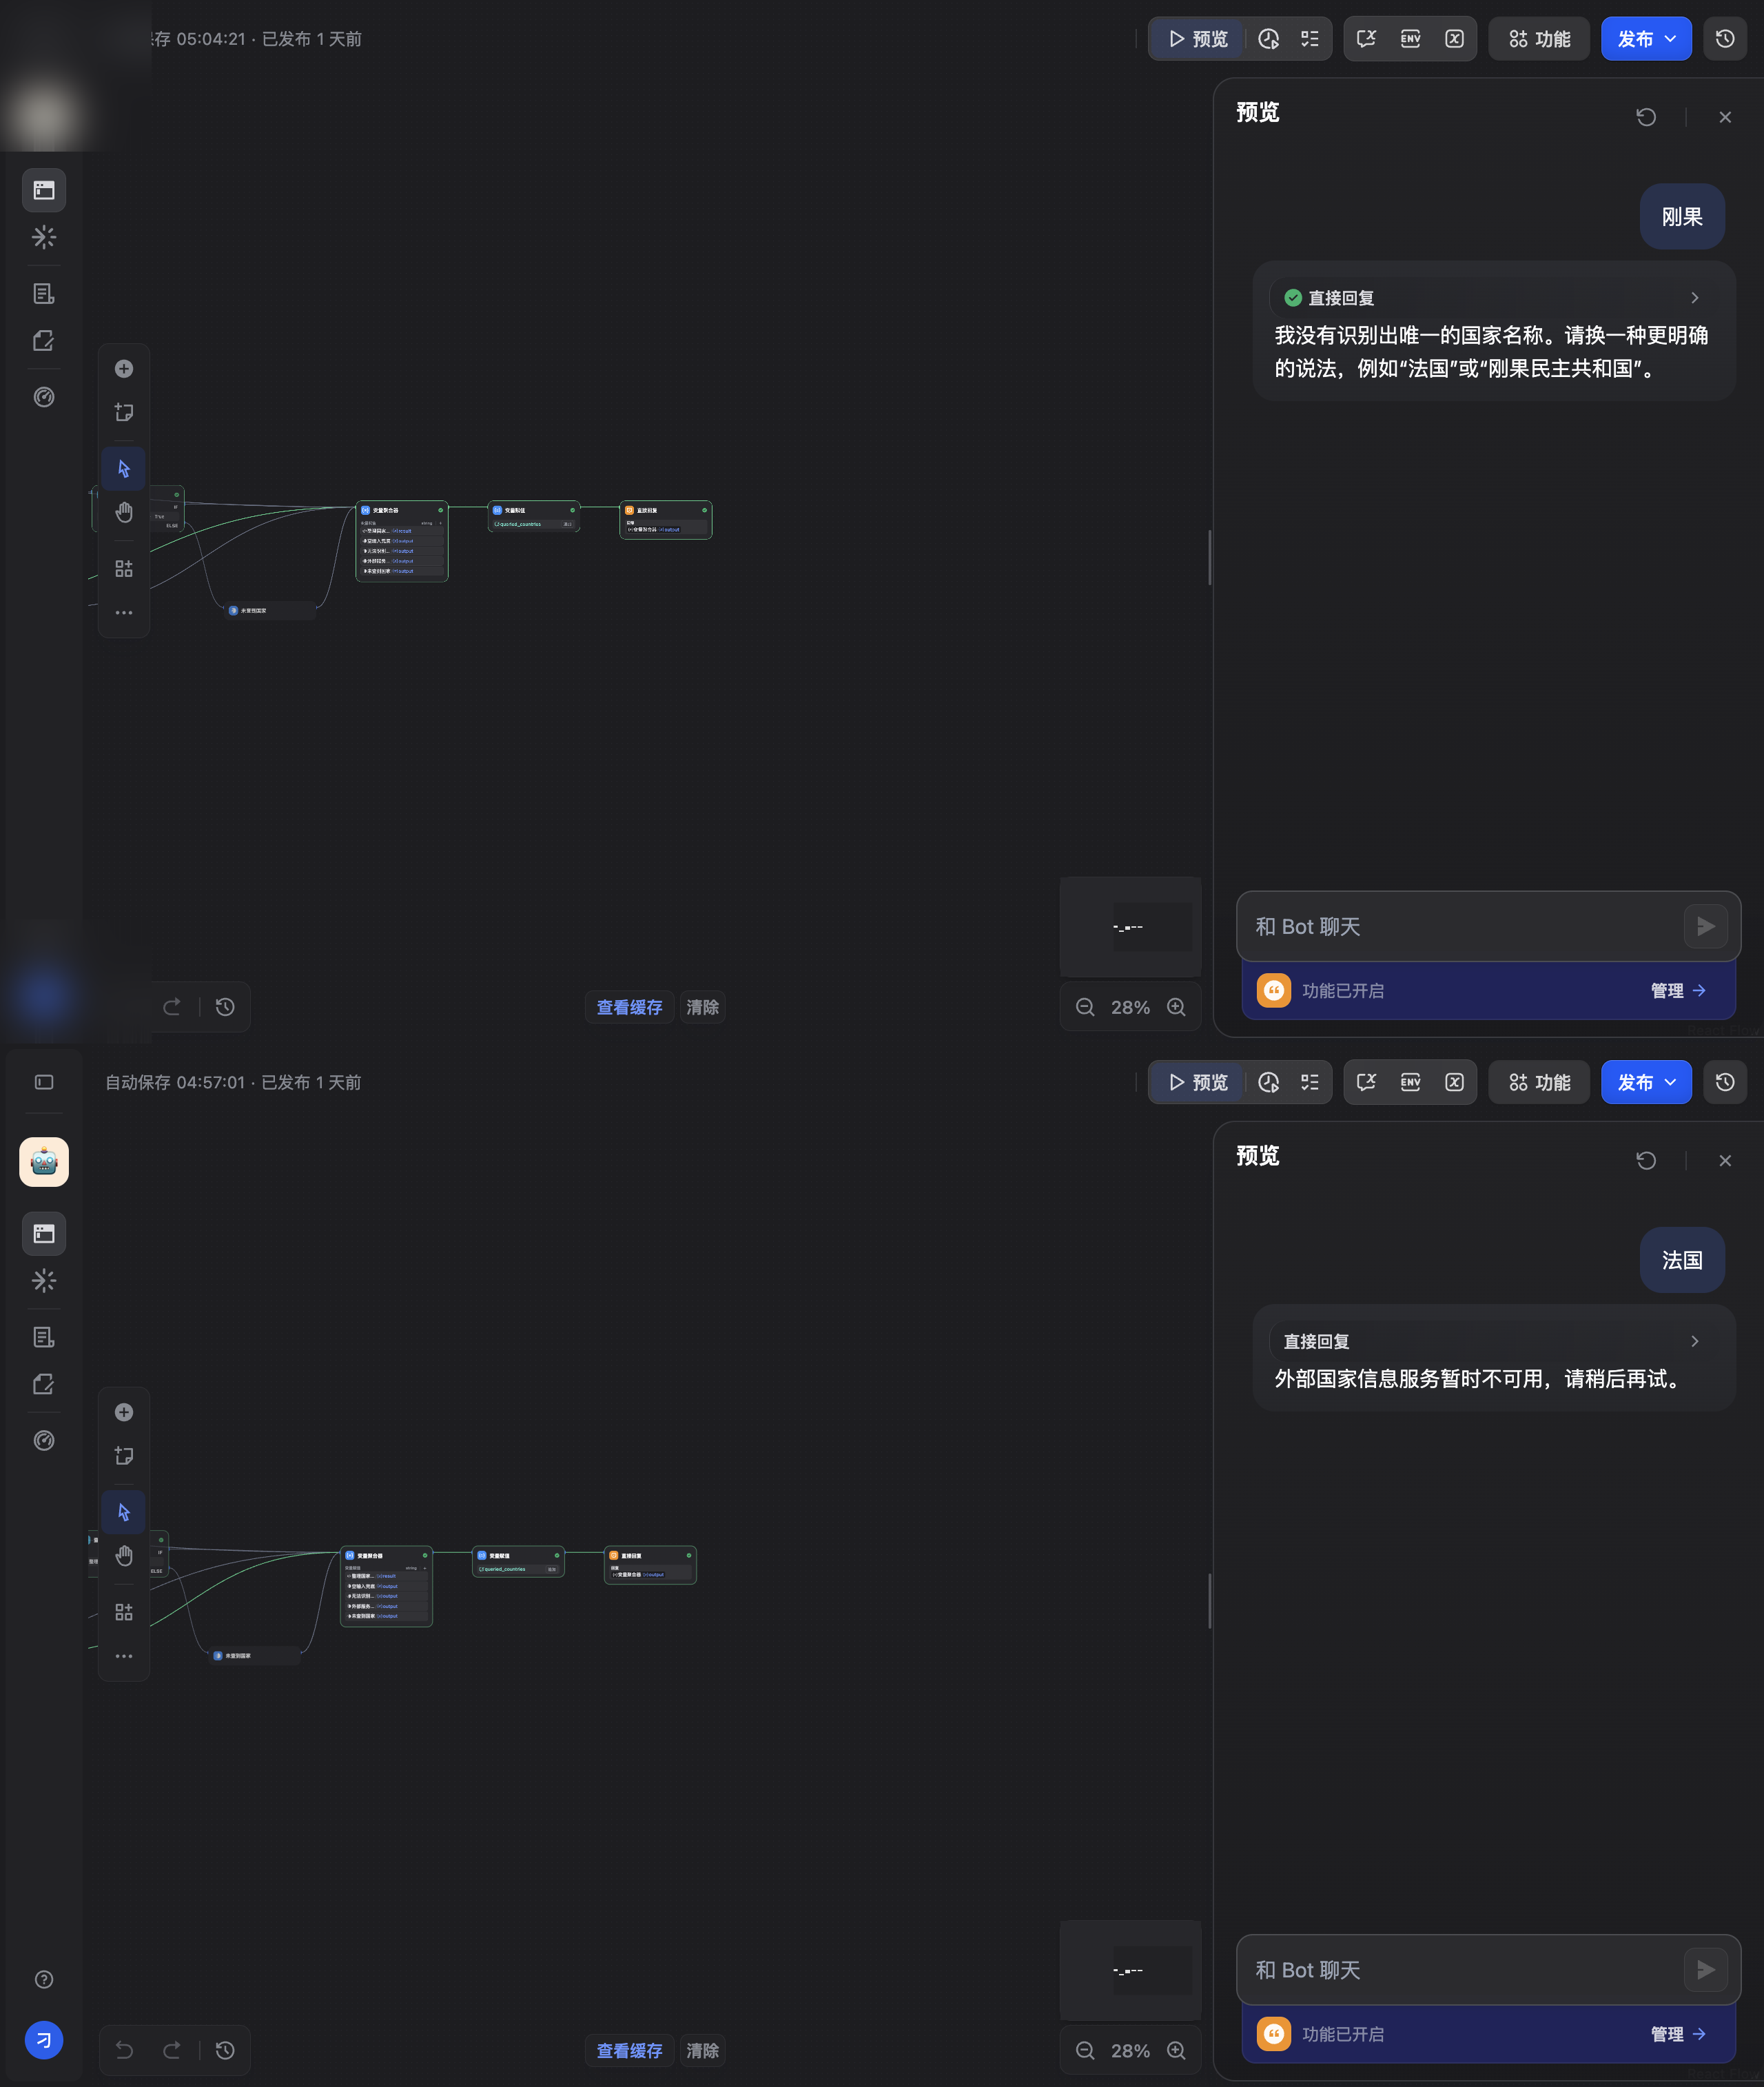
"刚果"可能指刚果共和国,也可能指刚果民主共和国。理想行为是参数提取器拒绝猜测,进入提取失败兜底,引导用户补充完整名称。
再输入一个拼错且无法识别的国家名。如果参数提取器仍然生成了某个英文名称,HTTP API 可能返回空数组;Code 应输出 ok = false,流程进入"未查到国家"兜底。两层防线分别覆盖了语言理解失败和外部查询无结果。
Key 无效或额度耗尽
在正式操作阶段,可以临时把环境变量换成一个明确无效的测试值,运行一次后立即恢复。预期行为是 HTTP Request 失败,工作流进入外部服务不可用的分支;最终回复不包含真实 Key,也不把接口原始错误堆栈直接展示给用户。
测试结束后检查运行日志:Secret 值应该被遮蔽,同时应能看到足以排障的状态码或错误摘要。截图前仍要人工检查页面,避免账户信息、工作空间名称或其他凭证进入图片。
网络超时或服务异常
网络故障不一定容易稳定复现。实操时可以把 URL 临时改成一个确认无法连接的测试地址,或把超时设置得极短来验证失败分支;测试后恢复正式 URL 和合理超时。
预期行为包括:节点按配置进行有限重试,重试结束后进入失败分支,用户收到简洁提示,变量聚合器与直接回复仍然只交付一次结果。
| 测试场景 | 预期节点路径 | 用户看到的结果 |
|---|---|---|
| 日本 | 提取成功 → HTTP 成功 → Code 成功 | 首都、货币、人口、面积 |
| 刚果 | 参数提取失败 | 请提供明确国家名 |
| 拼错且 API 返回空数组 | HTTP 成功 → Code ok = false |
没有查到国家 |
| Key 无效 | HTTP 失败分支 | 外部服务暂时不可用 |
| 网络超时 | 重试 → HTTP 失败分支 | 外部服务暂时不可用 |
错误处理的目标,是把失败限制在它发生的那一段。参数理解失败不该发请求,HTTP 失败不该让 Code 解析错误页,查无结果也不该伪装成一份正常的国家数据。
接上 API 之后,模型应该站在什么位置
改造前,LLM 直接回答国家事实。改造后,正常查询路径不再依赖 LLM 生成这些数字,参数提取器内部仍使用模型理解自然语言。
这是一种职责调整。模型继续处理表达上的不确定性,API 提供可追溯的结构化事实,Code 执行确定的转换规则。每一层都有自己的失败信号,工作流可以据此决定下一步。
如果以后希望回答更自然,可以在 Code 后面增加一个 LLM 节点,把已经整理好的事实改写成符合语气的回复。但提示词必须要求它只使用传入数据,不补充未提供的数字;关键字段仍应在改写前后校验。对于首都、人口、货币这样的短答案,当前模板已经足够清晰,多一次模型调用未必带来等量价值。
选择节点时,不要从"哪个节点更高级"出发。先判断这一段输入是什么、允许多大不确定性、失败后该由谁负责。画布上的节点数量并不能代表工程质量,边界能否说清楚才重要。
外部连接建立以后,数据来源仍然要被追问
这一集新增了三个概念:
- 参数提取器把自然语言转换成有名称、有类型的结构化字段;
- HTTP Request 按明确的 URL、参数、Header 和超时策略连接外部服务;
- Code 把外部 JSON 转换成稳定、可测试的应用输出。
我们也兑现了 EP4 留下的环境变量钩子:真实 API Key 进入 Secret 环境变量,节点只引用它,不在画布和代码里复制凭证。
更重要的变化发生在事实来源上。过去,"国家信息小助手"的答案只能追溯到某次模型生成;现在可以继续追到具体 API、请求参数、响应状态和格式化代码。外部数据并不会自动变得权威,但它第一次拥有了可以检查的来源和处理链路。
下一集会继续追问数据从哪里来,只是对象从公开 API 变成我们自己的资料:把文档送进知识库,理解切分、检索、Rerank 和生成之间的关系,完成一次真正的 RAG 实战。