MCP Python SDK 2.0:别把它当成一次改名升级
你把项目里的 mcp 升到 2.0,修掉第一个 ModuleNotFoundError,以为接下来只是继续改几个 import。可真正危险的地方可能根本不报错:程序还能跑,某些配置和数据却已经悄悄换了含义。
先用几句话说清 MCP 是什么。MCP(Model Context Protocol)有点像给 AI 准备的一套通用 USB 接口:工具、文件、数据库各不相同,但只要遵守同一套接口,AI 就能用相似的方式发现和调用它们。Python SDK 则是帮你实现这套接口的工具箱,让你不用从头处理消息格式、连接和错误。即使你不写协议底层,只要在做 AI 工具、Agent 或知识库应用,这次升级迟早会影响你。
这就是 MCP Python SDK 2.0 最值得警惕的地方:表面上是一批 API 改名,底下却换了一整套运行方式。
我的判断很明确:影响最大的不是 FastMCP 改名,而是 MCP 从“先保持一段连接,再连续办事”,转向“每次请求都带齐自己的信息”。如果你只用了高层装饰器,迁移并没有想象中可怕;如果你直接操作低层 Server、让服务端反过来询问客户端,或者部署了多个副本,就应该把它当成一次小型架构迁移。
先决定:现在迁,还是先锁版本
升级依赖有点像更换房子的水电系统:如果今天没有时间检查所有插座,就不要在无人看管时直接换总闸。
SDK 2.0 已经是稳定版本,直接执行 pip install mcp 会安装 2.x。1.x 进入维护模式,只继续接收安全修复和关键修复。
如果你暂时没有时间完成兼容测试,先明确锁住旧版本:
mcp>=1.28,<2
这段配置的作用很简单:告诉依赖管理工具“暂时不要自动跨进 2.0”。
但如果项目仍在活跃开发,我不建议长期停在 1.x。2.0 解决的是连接、横向扩容和可观测性这些基础问题,越晚迁移,围绕旧模式写下的代码就越多。
迁移前,先判断自己是哪类项目:
- 主要使用
@mcp.tool()、@mcp.resource()、@mcp.prompt():迁移通常比较可控。 - 直接使用低层
Server、自定义 handler、订阅或反向请求:需要重新检查交互流程。
不要只看项目代码量。一个只有几百行、却深度依赖旧连接方式的项目,迁移成本可能比一个使用高层 API 的大项目更高。
最大变化:从“打电话”变成“寄明信片”
旧式 session 很像打电话:先拨通,双方保持通话,后面的内容都建立在这条连接还存在的前提上。
现代 MCP 请求更像寄明信片:每一张都写好了地址和必要信息,任何合适的工作人员收到后都能独立处理,不必先找到上次接电话的那个人。
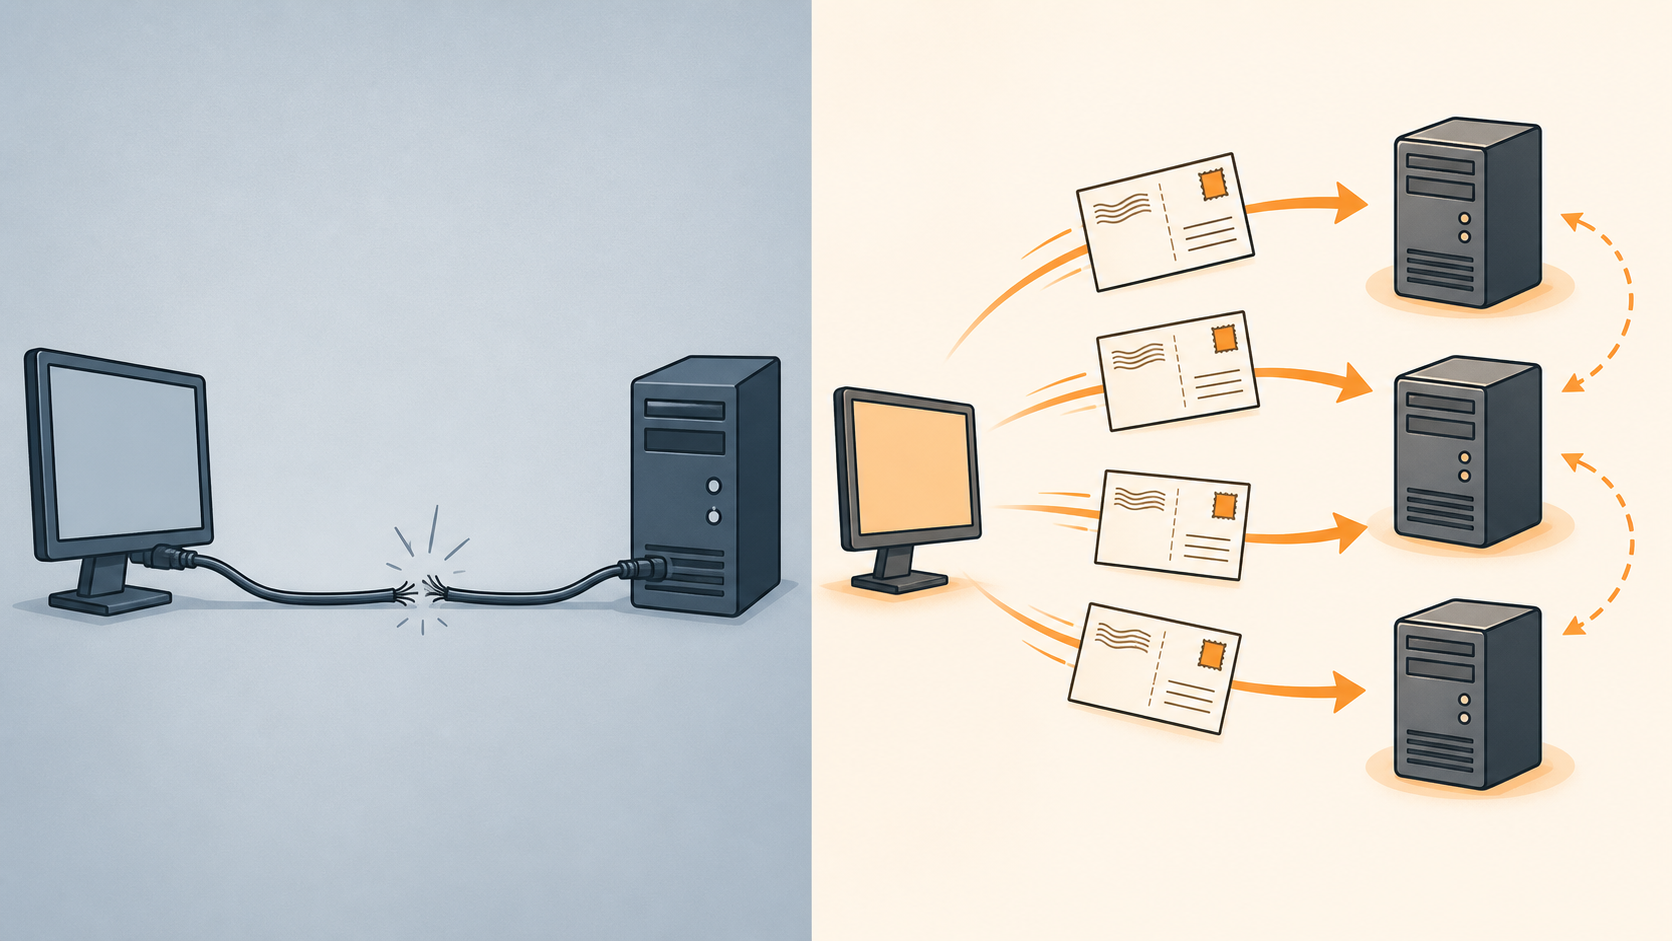
MCP 2026-07-28 取消了初始化握手和长生命周期 session。每个请求携带协议版本与客户端能力,因此可以由任意服务端实例处理。
这对部署很重要。以前 Streamable HTTP 可能需要把同一位客户端的请求持续送到同一个 worker,也就是 sticky routing。现代请求不再需要 Mcp-Session-Id,普通 round-robin 就能分发。
但别把它误解成“系统从此完全没有状态”。
旧协议客户端仍然需要 session;多轮交互会携带 request_state,多个服务副本必须共享 RequestStateSecurity(keys=[...]);订阅事件也需要共享 SubscriptionBus。否则,上一轮在 A 机器生成的状态,下一轮落到 B 机器时可能无法验证。
所以我的建议是:先迁源码,再单独做一次多副本设计检查。请求可以独立处理,不代表业务状态会自动同步。
现代客户端通过 server/discover 获取服务端能力。你可以把它理解成先问一句:“你会哪些功能、说哪个版本的协议?”高层 Client 默认使用 mode="auto",先尝试现代方式,不支持时再回退到旧式 initialize。
下面这段代码是在读取协商结果。过去有些值需要自己从初始化结果中保存,现在可以直接从对象属性上取得:
capabilities = session.server_capabilities
server_info = session.server_info
instructions = session.instructions
version = session.protocol_version
官方资料没有给出手写 ClientSession.discover() 的完整 Python 示例。如果你在做自定义客户端或网关,不要根据高层 Client 猜底层请求格式,应继续核对 API Reference。
第一批要改的代码:Server 名称与构造参数
类名改动就像商店换了门牌:不复杂,但旧地址已经不能用了。
下面的旧代码从 fastmcp 路径导入 FastMCP:
# Before
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("Demo")
2.0 要改为 MCPServer:
# After
from mcp.server.mcpserver import MCPServer, Context

mcp = MCPServer("Demo")
也可以从 mcp.server 导入 MCPServer。旧路径不是还能凑合使用的 deprecated alias,而是已经移除,所以会直接触发 ModuleNotFoundError。
更容易踩坑的是位置参数。位置参数就像表格里的“第二格、第三格”:一旦表格插入了新列,原来填在第二格的内容就可能被当成另一种数据。
旧代码把第二个位置参数当作 instructions:
# Before
mcp = FastMCP(
    "Demo",
    "You answer questions about the weather.",
)
2.0 增加了 title 和 description,应该明确写出参数名:
# After
mcp = MCPServer(
    "Demo",
    instructions="You answer questions about the weather.",
)
旧写法可能不会报错,只会把说明文字当成 title,让 instructions 静默丢失。迁移时最稳妥的规则是:只让 name 使用位置参数,其余全部写 keyword;业务 Server 的 version 也应显式传入,否则 v2 报告的是空字符串。
MCPServer.get_context() 同样被移除。Context 可以理解成快递单上的“本次请求信息”:进度、请求环境等数据都跟这次调用有关。以前代码会在函数内部偷偷从环境中取,现在要明确放进函数参数。
旧代码在工具内部获取 Context:
# Before
@mcp.tool()
async def my_tool(x: int) -> str:
    ctx = mcp.get_context()
    await ctx.report_progress(1, 2)
    return str(x)
新代码把依赖明确写在签名中:
# After
from mcp.server.mcpserver import Context

@mcp.tool()
async def my_tool(x: int, ctx: Context) -> str:
    await ctx.report_progress(1, 2)
    return str(x)
我认为这是一次值得欢迎的破坏性修改:你一眼就能看到函数依赖什么,测试时也更容易替换和检查。
统一 Client:最值得先采用的改进
旧客户端有点像每次出门都要自己准备车、司机和路线:先建立 transport,再创建 ClientSession,最后手工 initialize()。
2.0 的高层 Client 把这些步骤收进一个入口。目标可以是本地 Server 对象、HTTP URL、stdio 参数或自定义 transport。
下面的旧测试代码负责手工创建一对互相连接的 Server 和 Client session:
# Before
from mcp.shared.memory import create_connected_server_and_client_session

async with create_connected_server_and_client_session(server) as session:
    result = await session.call_tool("my_tool", {"x": 1})
新写法直接把 Server 交给 Client,进入 async with 时会自动连接和协商:
# After
from mcp.client import Client

async with Client(server) as client:
    result = await client.call_tool("my_tool", {"x": 1})
这是我建议最先完成的一步。统一 Client 后,本地测试和实际部署可以共用一套调用方式,后续排查协议差异也更容易。
不过,Client(server) 默认使用现代协议。如果工具仍调用 ctx.elicit()、Sampling 或 Roots,就像你在寄明信片时突然要求对方立刻接起电话:现代协议没有这条反向通道,会抛出 NoBackChannelError。
迁移期间,可以用下面这段配置专门测试旧协议:
Client(server, mode="legacy", ...)
它的作用是暂时走回旧式连接,但这只是兼容性测试手段,不应成为长期方案。
服务端不能再“执行到一半回头提问”
旧模型像客服通话:服务端处理到一半发现信息不够,可以直接问客户端“你确认吗?”
现代模型更像办事窗口:材料不齐时,窗口把“还缺什么”交还给你;你补齐后,再带着完整材料重新提交。
高层 API 用 Resolve 处理这个多轮过程:
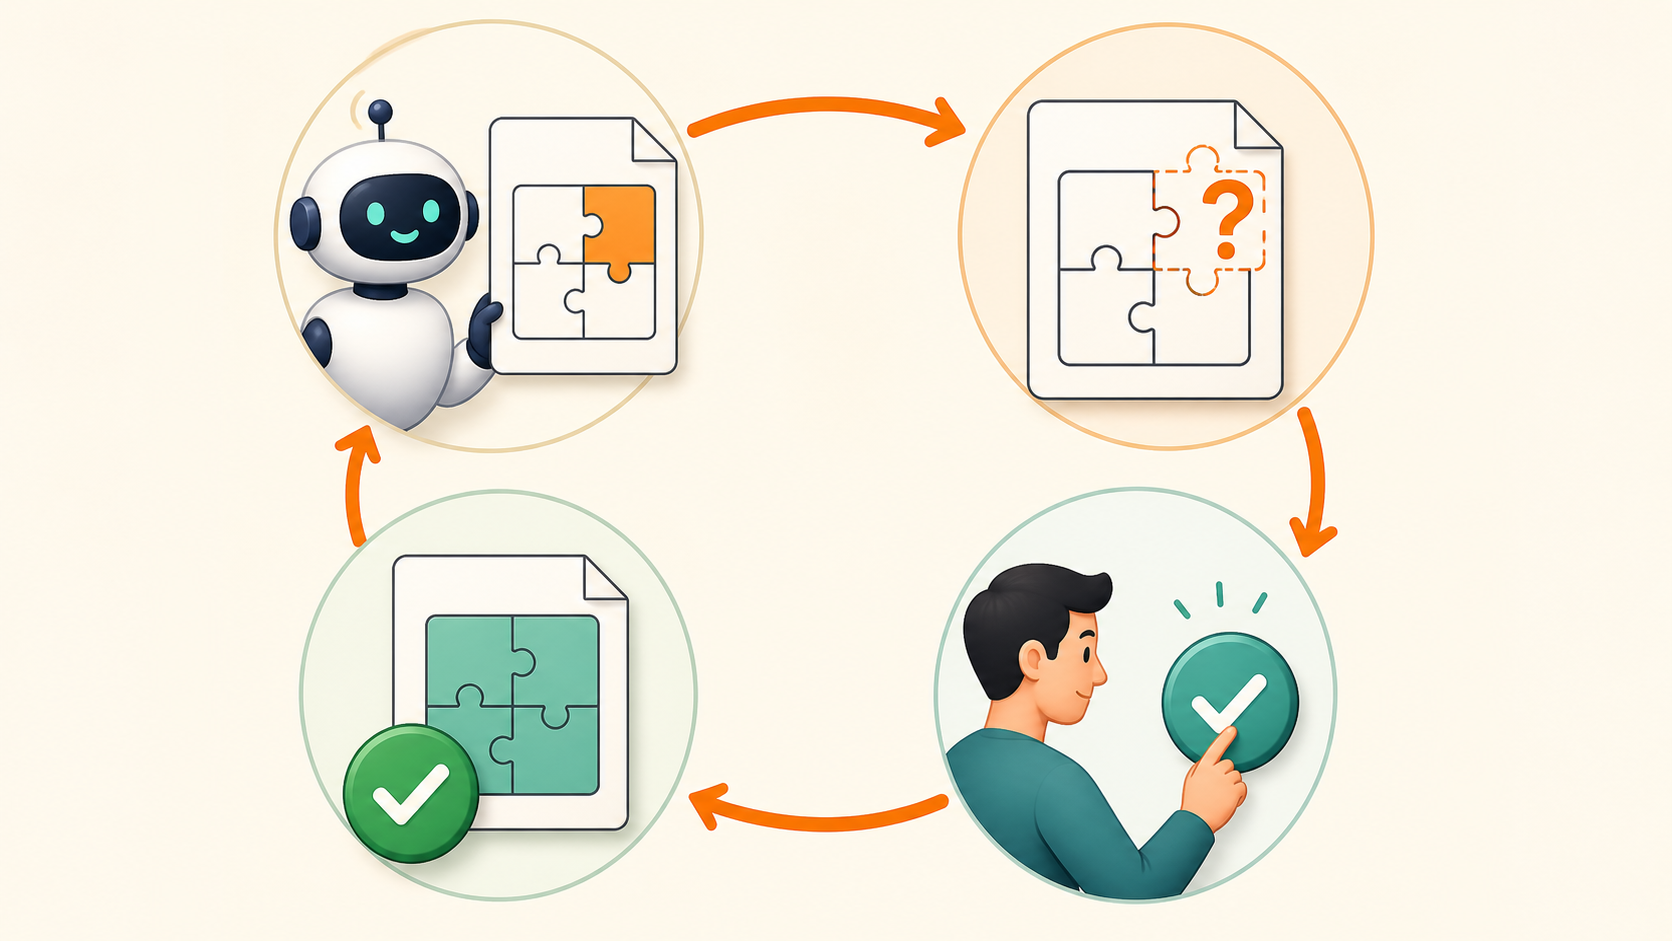
下面的旧工具会在执行过程中主动调用 ctx.elicit(),询问是否确认订桌:
# Before
@mcp.tool()
async def book_table(date: str, ctx: Context) -> str:
    result = await ctx.elicit(
        f"Book a table for {date}?",
        schema=Confirmation,
    )
    if result.action == "accept" and result.data.confirm:
        return f"Booked for {date}."
    return "No booking made."
新代码把“如何取得确认”独立成 resolver,再由 Resolve 填入答案:
# After
from typing import Annotated
from mcp.server.mcpserver import Elicit, Resolve


async def ask_to_confirm(date: str) -> Elicit[Confirmation]:
    return Elicit(f"Book a table for {date}?", Confirmation)


@mcp.tool()
async def book_table(
    date: str,
    answer: Annotated[Confirmation, Resolve(ask_to_confirm)],
) -> str:
    if answer.confirm:
        return f"Booked for {date}."
    return "No booking made."
这里最重要的不是语法,而是 answer 不会作为普通工具参数暴露给模型。它由 resolver 提供,可以来自用户确认、配置或其他受控来源。
涉及付款、审批、目标账号或不可逆操作时,这个边界非常有价值:模型可以提出“我要做什么”,但不能猜测本应由用户确认的关键事实。
snake_case:看起来只是改名,却容易漏
Python 世界习惯 snake_case,JSON API 常见 camelCase。它们就像同一个人的中文名和护照拼音:含义相同,但使用场合不同。
2.0 把 Python 属性统一改成 snake_case,JSON wire format 仍然保持 camelCase。
下面的旧代码使用 camelCase 访问返回对象:
# Before
result = await session.call_tool("my_tool", {"x": 1})
if result.isError:
    ...

tools = await session.list_tools()
cursor = tools.nextCursor
schema = tools.tools[0].inputSchema
新代码要改成 Python 风格的属性名:
# After
result = await session.call_tool("my_tool", {"x": 1})
if result.is_error:
    ...

tools = await session.list_tools()
cursor = tools.next_cursor
schema = tools.tools[0].input_schema
迁移时至少全局搜索 .isError、.nextCursor、.inputSchema、.structuredContent、.serverInfo、.protocolVersion 和 .mimeType。
如果你自己把模型转成 JSON,还要告诉 Pydantic 使用 wire alias。下面第一行输出 Python 字段名,第二行才输出协议需要的 camelCase:
tool.model_dump()
tool.model_dump(by_alias=True, mode="json")
忘记 by_alias=True 不一定立刻报错,但其他 MCP 实现可能看不懂你生成的数据。这类“本机正常、联调失败”的问题,通常比明确异常更难查。
自定义字段为什么会悄悄消失
协议模型有点像一张固定格式的申请表:2.0 只保留表格认识的栏目,自己在空白处加的一栏可能会被忽略。
下面这段代码尝试加入 unknown_field。模型不会保存它,而且不会专门报错:
from mcp.types import CallToolRequestParams

params = CallToolRequestParams(
    name="my_tool",
    arguments={},
    unknown_field="value",
)

"unknown_field" in params.model_dump()  # False
如果确实需要携带自定义信息,应放入协议预留的 _meta:
params = CallToolRequestParams(
    name="my_tool",
    arguments={},
    _meta={
        "my_custom_key": "value",
        "another": 123,
    },
)
如果你把 tenant、routing、trace 或业务标识直接塞进顶层字段,这一项应排在迁移检查清单最前面。它不会用异常提醒你,只会让数据在升级后安静地消失。
低层 Server:不是改个类名就结束
高层 MCPServer 像餐厅套餐:参数检查、结果包装等常见工作已经替你准备好。低层 Server 更像自己租厨房,控制更细,但每一道工序都得自己负责。
旧版低层 Server 可以用 decorator 注册 handler,并直接返回工具列表:
# Before
from mcp.server.lowlevel.server import Server
import mcp.types as types

server = Server("my-server")


@server.list_tools()
async def handle_list_tools():
    return [
        types.Tool(
            name="my_tool",
            description="A tool",
            inputSchema={},
        )
    ]
2.0 改为通过构造器的 on_* 参数注册,并要求 handler 返回完整 Result 类型:
# After
from mcp.server import Server, ServerRequestContext
from mcp.types import ListToolsResult, PaginatedRequestParams, Tool


async def handle_list_tools(
    ctx: ServerRequestContext,
    params: PaginatedRequestParams | None,
) -> ListToolsResult:
    return ListToolsResult(
        tools=[
            Tool(
                name="my_tool",
                description="A tool",
                input_schema={"type": "object"},
            )
        ]
    )


server = Server("my-server", on_list_tools=handle_list_tools)
低层 call_tool 不再自动做 JSON Schema 参数校验,也不会自动包装 dict、list 或异常。
我的建议很直接:除非你确实需要 JSON-RPC 级控制,否则优先使用高层 MCPServer。低层 API 不是“更专业”的勋章,它意味着输入校验、错误转换和返回值结构都由你承担。
还有三件运行时变化要留意
第一是订阅。订阅就像关注快递状态:客户端打开一条监听流,服务端有变化时再通知它。现代客户端统一使用 subscriptions/listen:
async with client.listen(
    resource_subscriptions=["board://sprint"],
) as sub:
    async for event in sub:
        ...
旧的 subscribe_resource() 和 unsubscribe_resource() 已被标记为 deprecated;对现代服务端调用会得到 -32601 Method not found。服务端改用 ctx.notify_tools_changed()、ctx.notify_prompts_changed()、ctx.notify_resources_changed() 或 ctx.notify_resource_updated(uri)。
官方资料列出了这些 API,但没有给出共享 SubscriptionBus 和低层 Server 发布事件的完整实现。多副本生产环境不能只凭单进程示例判断订阅已经可靠。
第二是 transport 配置。它可以理解成“服务通过哪扇门对外营业”。相关参数从 Server 构造器移到了 run() 或 app builder:
mcp = MCPServer("Demo")

mcp.run(
    transport="streamable-http",
    host="0.0.0.0",
    port=9000,
    json_response=True,
    stateless_http=True,
)
第三是 OpenTelemetry。它像给一次请求贴上可追踪的快递编号,让你看到调用从 Client 到 Server 再到工具的整条路径。2.0 默认创建相关 span,并通过 _meta 传播 traceparent。
如果应用已经配置全局 tracer provider,升级后会自动开始记录 MCP span。客户端 tracing 目前没有公开的关闭开关;不希望导出时,需要在 telemetry pipeline 中过滤 mcp-python-sdk tracer。
三个我不会替官方猜的地方
第一,官方说明了 ClientSession.discover(),但现有材料没有给出完整直接调用示例。自定义客户端应该继续查 API Reference,不能凭高层行为拼请求。
第二,多副本多轮交互需要共享 RequestStateSecurity 密钥,但 request_state 的大小、密钥轮换、重放保护和隐私成本没有在现有材料中展开。涉及网关和安全审计时,这仍是待验证项。
第三,subscriptions/listen 的客户端示例很清楚,但共享 SubscriptionBus、低层发布和订阅过滤缺少完整示例。单机跑通并不能证明生产拓扑正确。
保留这些“不知道”,比补一个看似完整、实际未经官方确认的实现更专业。
我建议你这样迁移
迁移不要像在黑暗中一次性搬家,而应该像过四道检查站:先盘点,再双路测试,然后切换,最后验证部署。
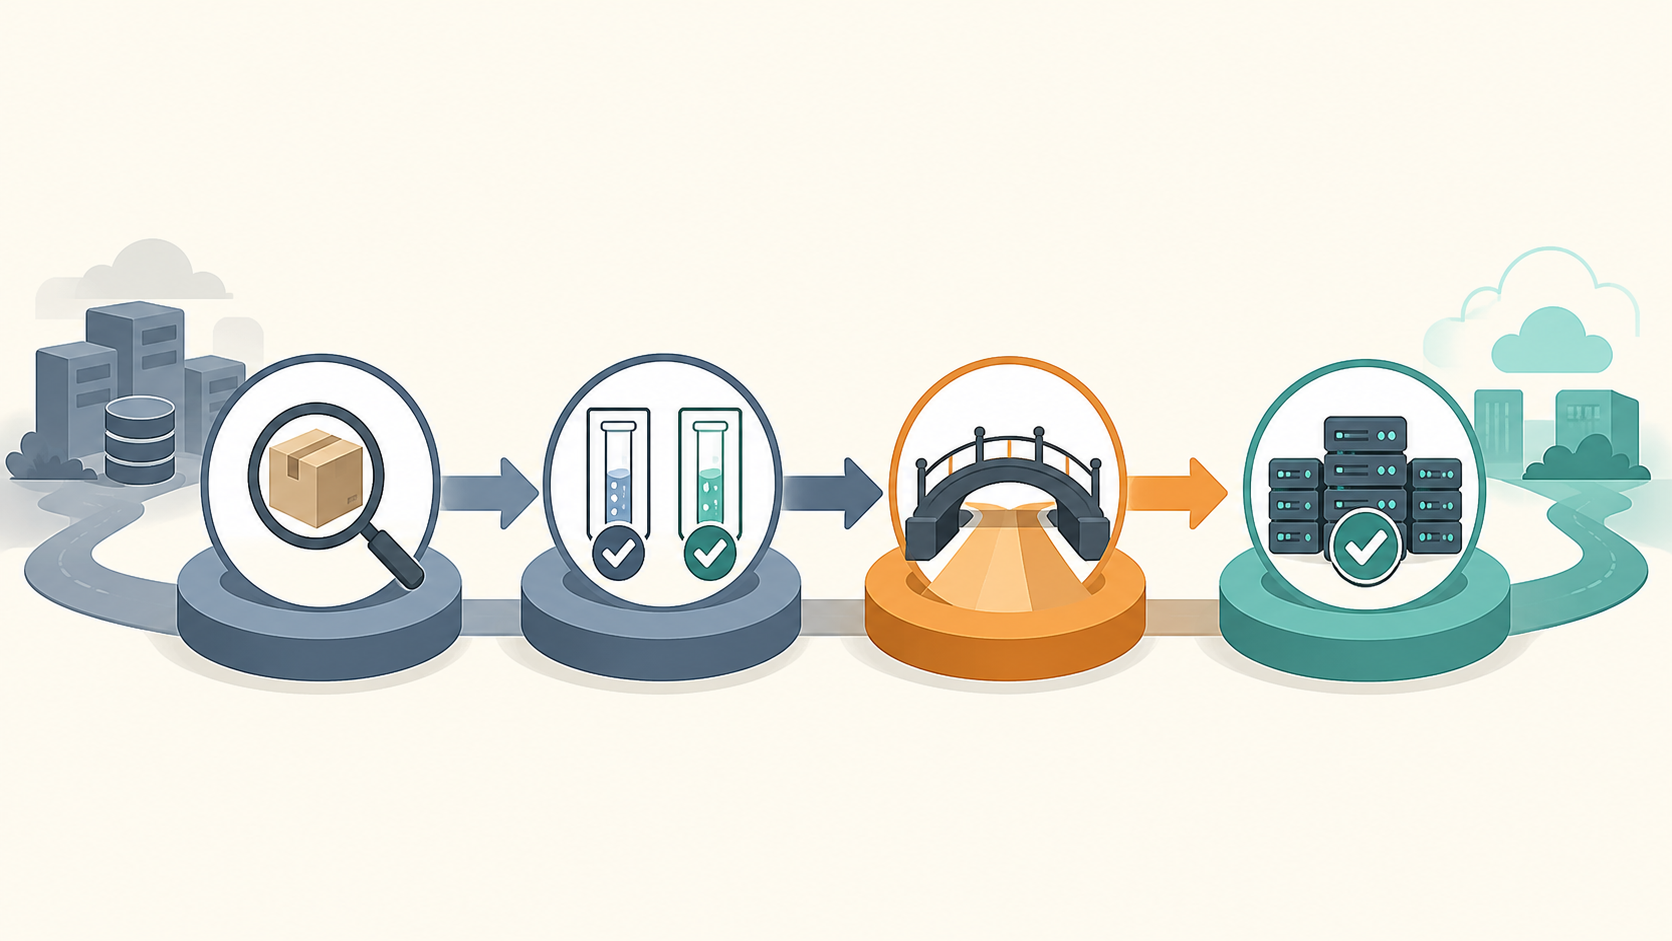
建议顺序是:
- 锁定当前依赖,建立现代与 legacy 两组测试。
- 改用统一
Client,找出依赖旧 back-channel 的功能。 - 搜索 snake_case、未知顶层字段和位置参数这三类静默风险。
- 完成
MCPServer、Context 注入和 transport 配置迁移。 - 把
ctx.elicit()等反向请求改成Resolve。 - 最后单独验证低层 Server、订阅、多副本状态与 telemetry。
完整资料可以从 What's new in MCP Python SDK v2、v1 → v2 Migration Guide 和 v2.0.0 Release 开始阅读。
最后一句判断:活跃项目现在就应该开迁移分支,但先用测试锁住现代协议和旧协议两条路径;如果近期做不完,就明确固定在 1.x,绝不要让一次普通安装替你完成这场架构升级。