别把循环当复制粘贴:用 Dify 批量处理一组数据
前六集里,我们已经让 Dify 学会了分支、变量、外部 API 和知识库。可这些流程大多一次只处理一个输入:问一个国家、调一次接口、检索一次知识。
真实业务很快会遇到另一类问题:用户一次上传 10 份文件,接口一次返回 20 条记录,或者模型一次拆出 8 个章节。你当然可以复制 8 个节点,但数据数量一变化,画布就会失控。
这一集专门解决“重复”——先把输入整理成列表,用 Iteration 对每一项执行相同步骤;再用 Loop 处理“上一轮结果要进入下一轮”的渐进任务。两个节点看起来都在重复执行,数据关系却完全不同。
前情提要:EP6 讲的是“从一组文档中找出相关片段”,本集继续处理“组”的概念,但方向相反:知识检索从许多片段中选出少数候选;Iteration 把一个数组拆开,让每个元素分别进入同一段子流程。
| # | 主题 | 一句话 | 状态 |
|---|---|---|---|
| 1 | AI 应用平台通识与选型 | 看懂平台位置与选型边界 | 已发布 |
| 2 | 云版搭第一个 Chatflow 应用 | Start、LLM、Answer 与发布 | 已发布 |
| 3 | 给应用装上“分岔路” | If/Else 与问题分类器 | 已发布 |
| 4 | 变量,这个系列真正的地基 | 会话变量、环境变量与赋值 | 已发布 |
| 5 | 把外部世界接进来 | HTTP Request、Code、参数提取器 | 已发布 |
| 6 | 知识库与 RAG 实战 | 文档处理、分段、检索策略与 Rerank | 已发布 |
| 7 | 批量处理与循环 | Iteration、Loop、列表操作 | ← 你在这里 |
| 8 | 工具与 Agent | 工具市场、ReAct、Function Calling、MCP | 已发布 |
| 9 | 从 Demo 到生产:运维篇 | 版本、日志、标注、可观测性与权限 | 已发布 |
| 10 | 私有化部署实战 | Docker Compose、配置与排错 | 已发布 |
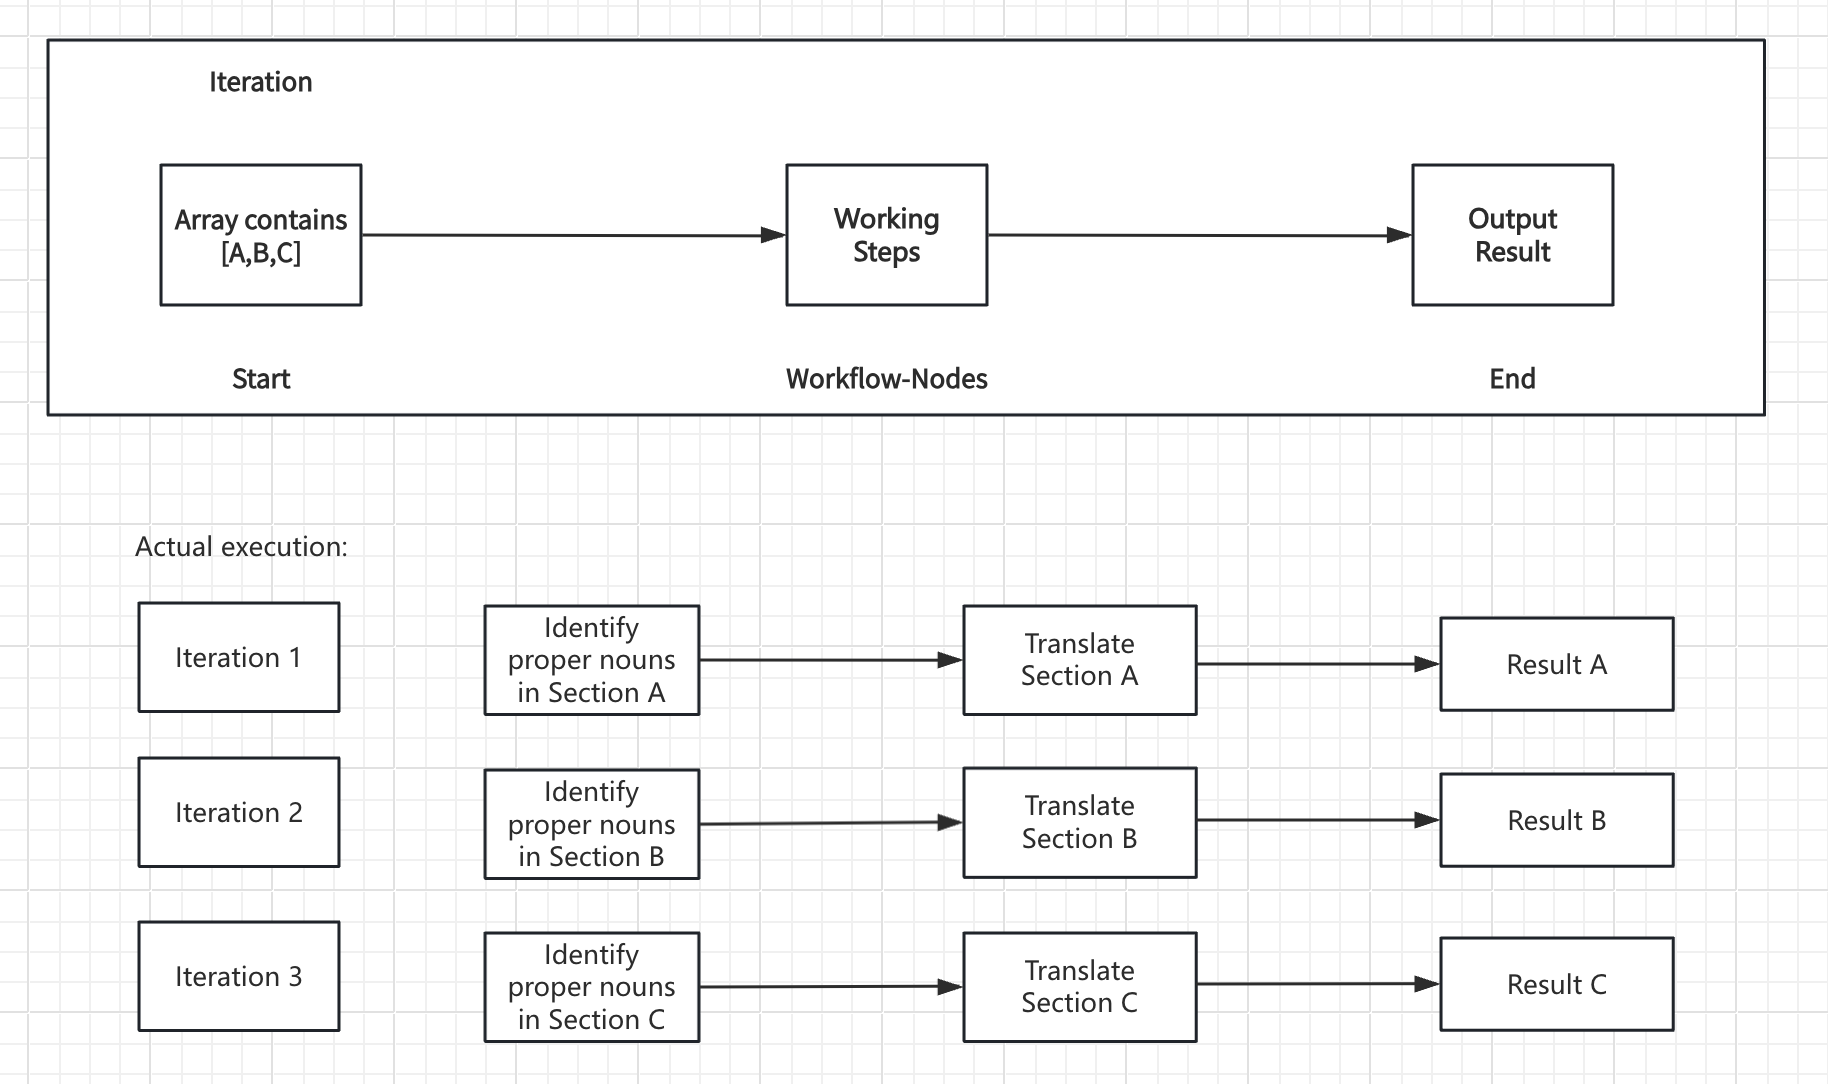
先用一句话分清 Iteration 和 Loop
判断时只问一个问题:下一次执行,是否依赖上一次的结果?
| 任务 | 该用什么 | 原因 |
|---|---|---|
| 把 10 个标题分别翻译成英文 | Iteration | 每个标题可以独立处理 |
| 给 8 份文件分别生成摘要 | Iteration | 每份文件各跑一次相同流程 |
| 把一篇文章连续润色 3 轮 | Loop | 第二轮必须读取第一轮文本 |
| 反复检查答案,直到评分大于 0.9 | Loop | 状态和评分随轮次变化 |
| 从文件数组中只选 PDF,再取前 5 个 | 列表操作符 | 先筛选、排序、截取,还没有执行批处理 |
Iteration 的输入是一组元素,输出仍是一组结果;每一项之间原则上彼此独立。Loop 处理的是同一份状态:本轮读入旧值,产生新值,再交给下一轮。
实战任务:批量生成一组内容卡片草稿
本集设计一个最小但可迁移的工作流。用户在开始节点输入多行主题,例如:
Dify 里的环境变量
什么时候用 HTTP Request
RAG 为什么先测召回
Iteration 和 Loop 的区别
工作流把它们逐行整理成数组,再为每个主题生成一张“标题 + 一句话解释 + 一个避坑点”的文本卡片,最后合并成完整结果。
最小链路是:
Start → Code(文本转数组)→ Iteration(逐项处理)→ Template(数组转文本)→ Answer
这条链路故意不依赖外部数据源。理解它以后,可以把 Iteration 内部的节点换成 HTTP Request、知识检索、文档提取器或图像理解,数据结构仍然成立。
第一步:开始节点收一段多行文本
在 Start 节点新增字符串变量 topics_text,设为必填。为了避免读者不知道格式,输入说明写清楚:
每行一个主题;空行会被忽略。建议先输入 3~5 行进行测试。
这里先收字符串,而不是直接要求普通用户构造 JSON 数组。界面友好的输入格式与工作流内部数据结构可以不同,中间用确定性的 Code 节点转换。
第二步:Code 节点把文本变成数组
新增 Code 节点,输入变量 topics_text 引用开始节点的同名变量,输出变量声明为 topics,类型选择 Array[String]。
Python 代码如下:
def main(topics_text: str) -> dict:
    topics = []
    seen = set()

    for line in (topics_text or "").splitlines():
        topic = line.strip().lstrip("-•0123456789.、 ")
        if not topic or topic in seen:
            continue
        seen.add(topic)
        topics.append(topic)

    if not topics:
        raise ValueError("至少输入一个非空主题")

    if len(topics) > 20:
        raise ValueError("一次最多处理 20 个主题")

    return {"topics": topics}
这段代码做了四件小事:按行拆分、去掉空白、按原顺序去重、限制最大数量。限制数量不是多余的“防御性编程”;后面每个元素都可能调用一次模型或 API,20 个输入就可能意味着 20 次计费和 20 份失败机会。
Iteration 的三个变量合同
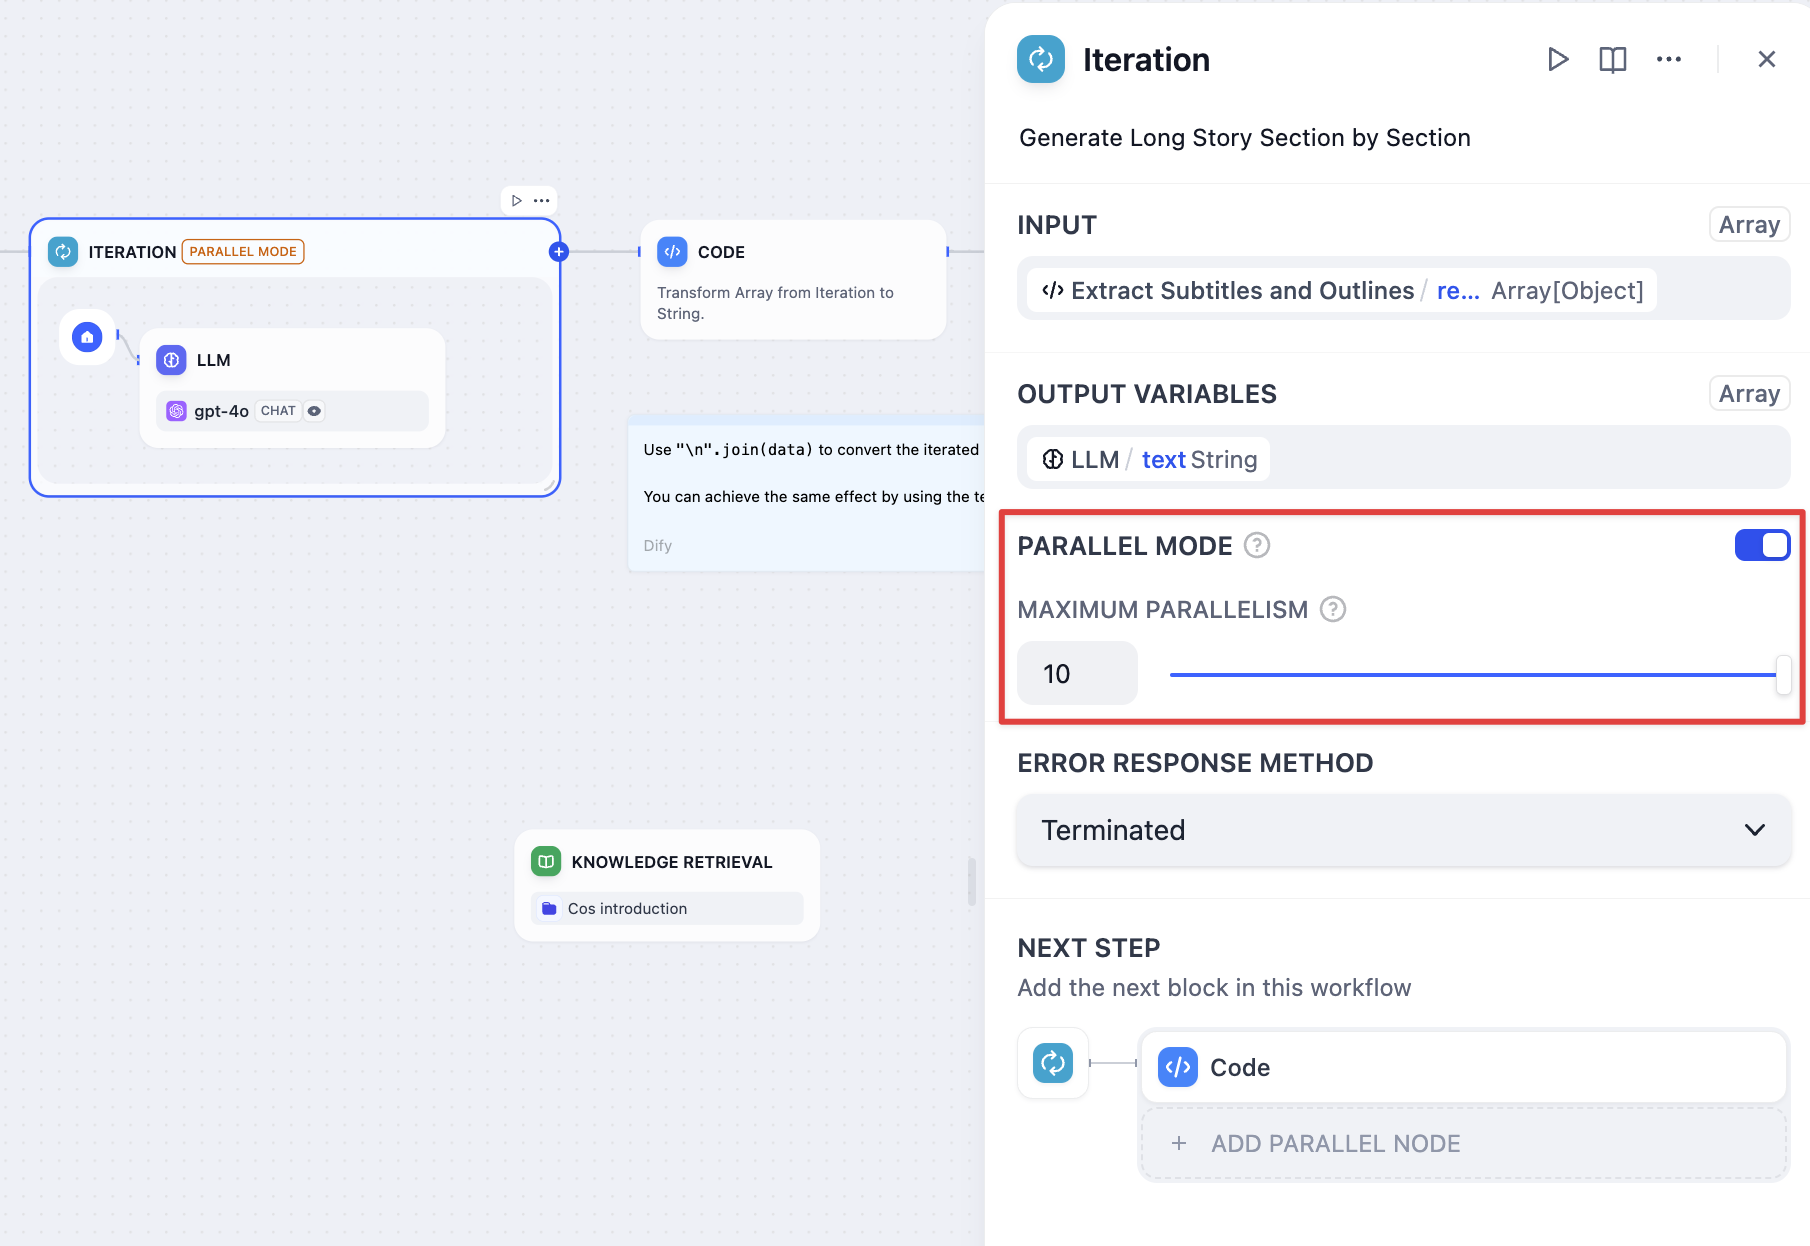
把 Code 的 topics 连接到 Iteration 输入后,先确认三件事:
- 输入必须是数组,不是长得像数组的字符串;
- 子流程内部用
items取得当前元素; - 用
index取得当前下标,下标从 0 开始。
假设输入是 ["环境变量", "HTTP Request", "RAG"],Iteration 会分别启动三次子流程。第一次 items 是“环境变量”、index 是 0;第二次换成“HTTP Request”和 1。内部节点不应该再次读取整个 topics 数组,否则你会在每一轮重复处理全部数据。
子流程里到底放什么
在 Iteration 容器内部放一个 LLM 节点,用户消息只引用当前的 items。System Prompt 可以写成:
你是 Dify 技术教程编辑。
请围绕当前主题输出一张纯文本知识卡,严格包含三行:
标题:不超过 18 个汉字
解释:用一句话说清概念
避坑:指出一个最容易犯的错误
不要输出 Markdown 代码围栏,不要补充第四行。
User 消息引用:
当前主题:{{ Iteration.items }}
模型调用放在 Iteration 里面,意味着数组有几项,模型通常就调用几次。因此必须先用 2~3 个元素小跑,再放大批次。不要一上来塞 100 项,然后把超时、限流和费用都归咎于“循环不稳定”。
如果任务是确定性转换,例如统一大小写、补 URL 前缀、字段映射,优先用 Code 或 Template,不要为每个元素调用 LLM。批量节点放大效率,也会等比例放大浪费。
顺序还是并行,不是越快越好
Dify 官方当前文档给出的并行上限是最多同时处理 10 个项目。并行适合彼此独立、顺序无关的任务,例如分别摘要 10 份文档。顺序模式则适合需要稳定顺序、较低资源占用或渐进式输出的场景。
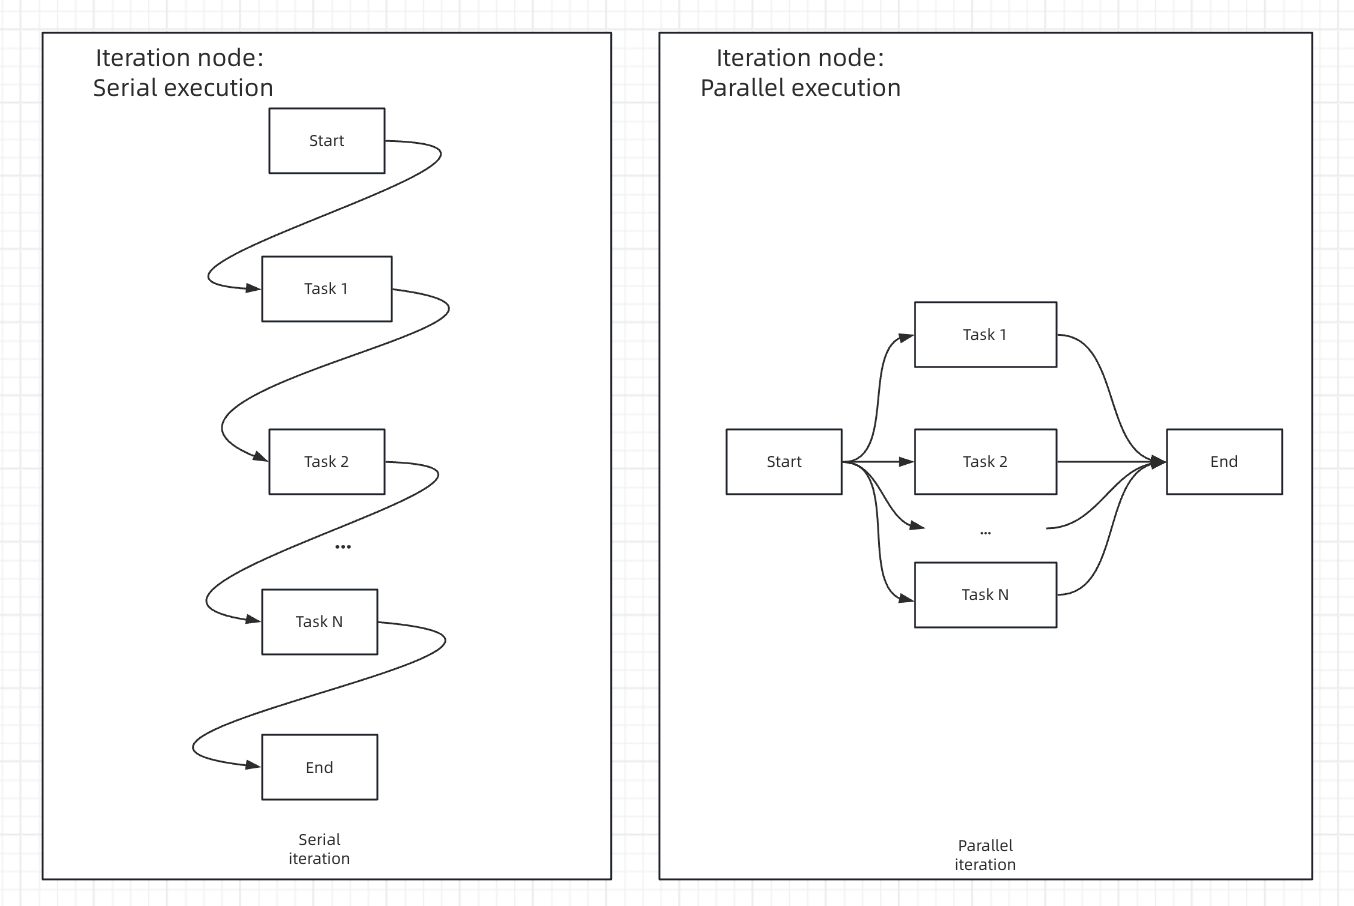
选择并行前检查三类风险:
- 外部 API 是否有每秒请求限制;
- 下游写操作是否会争抢同一条记录;
- 结果是否要求严格保持业务顺序。
并行度 10 是平台能力上限,不是推荐默认值。遇到第三方接口限流,可以先从 2 或 3 开始;批量创建订单、扣款或写数据库时,还要有幂等键,不能靠“节点只运行一次”的想象保证安全。
单项失败时,数组形状会变化
Iteration 提供三种错误处理思路:
| 策略 | 输入 [A,B,C],B 失败后的结果 |
适用场景 |
|---|---|---|
| 终止 | 整批停止并报错 | 每一项都不可缺失 |
| 错误时继续 | [resultA, null, resultC] |
必须保留输入与输出位置对应 |
| 移除失败结果 | [resultA, resultC] |
只关心成功项,不依赖原下标 |
这是很容易被忽略的数据合同。选择“移除失败结果”后,输出数组长度可能比输入短,result[1] 已经不再对应原来的 B。若后续要把结果写回原记录,应在每项输出中同时带上原始 ID 或 index,不能靠数组位置猜。
一个实用输出结构是:
{
  "index": 2,
  "source": "RAG 为什么先测召回",
  "ok": true,
  "content": "……",
  "error": ""
}
这样无论是否并行、是否跳过失败项,下游都能知道结果属于谁。
Iteration 输出仍是数组,别直接扔给 Answer
内部 LLM 节点每轮输出一个字符串,Iteration 会把它们收集成 Array[String]。Answer 节点最终需要可读文本时,应先显式合并。
最简单的 Template 写法:
{{ article_cards | join("\n\n---\n\n") }}
也可以使用 Code:
def main(article_cards: list) -> dict:
    clean = [item for item in article_cards if item]
    return {
        "result": "\n\n---\n\n".join(clean),
        "success_count": len(clean),
        "total_count": len(article_cards),
    }
第二种写法多返回了成功数和总数,便于向用户说明“共处理 5 项,成功 4 项”,也便于下一集运维篇接入日志和指标。
列表操作符:进入 Iteration 前先整理队伍
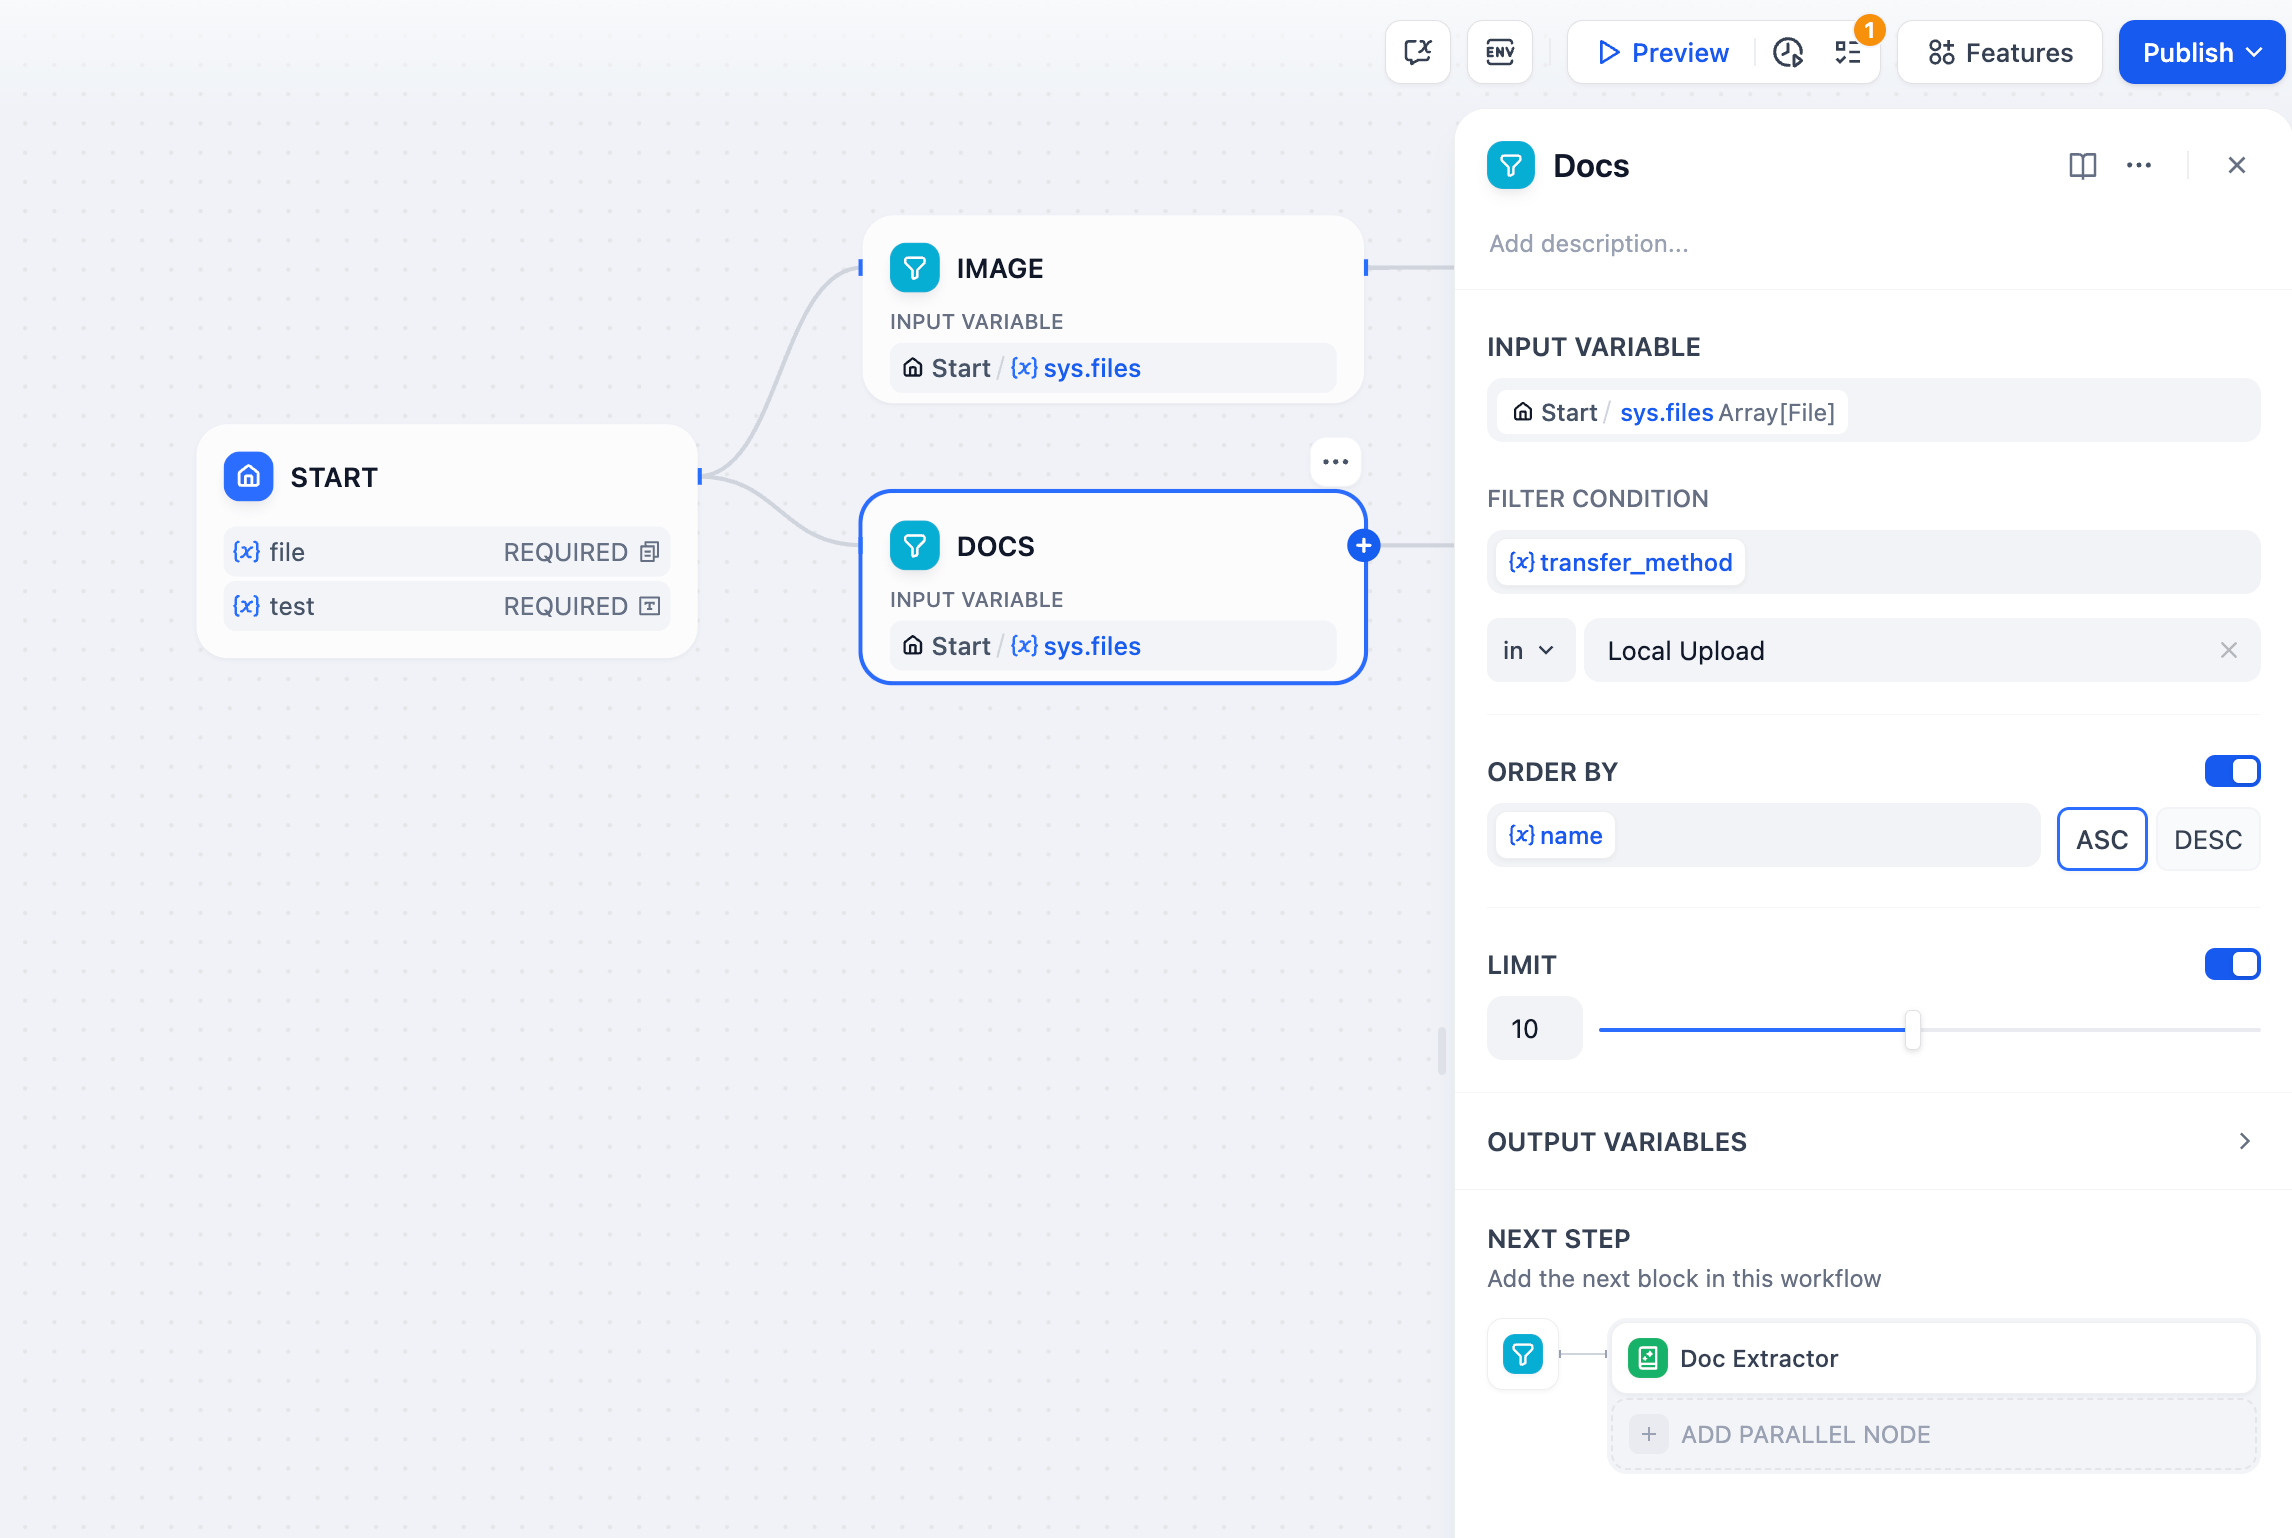
并不是拿到数组就应该立刻开始迭代。列表操作符可以先筛选、排序和截取,支持 array[string]、array[number]、array[file] 和 array[boolean]。
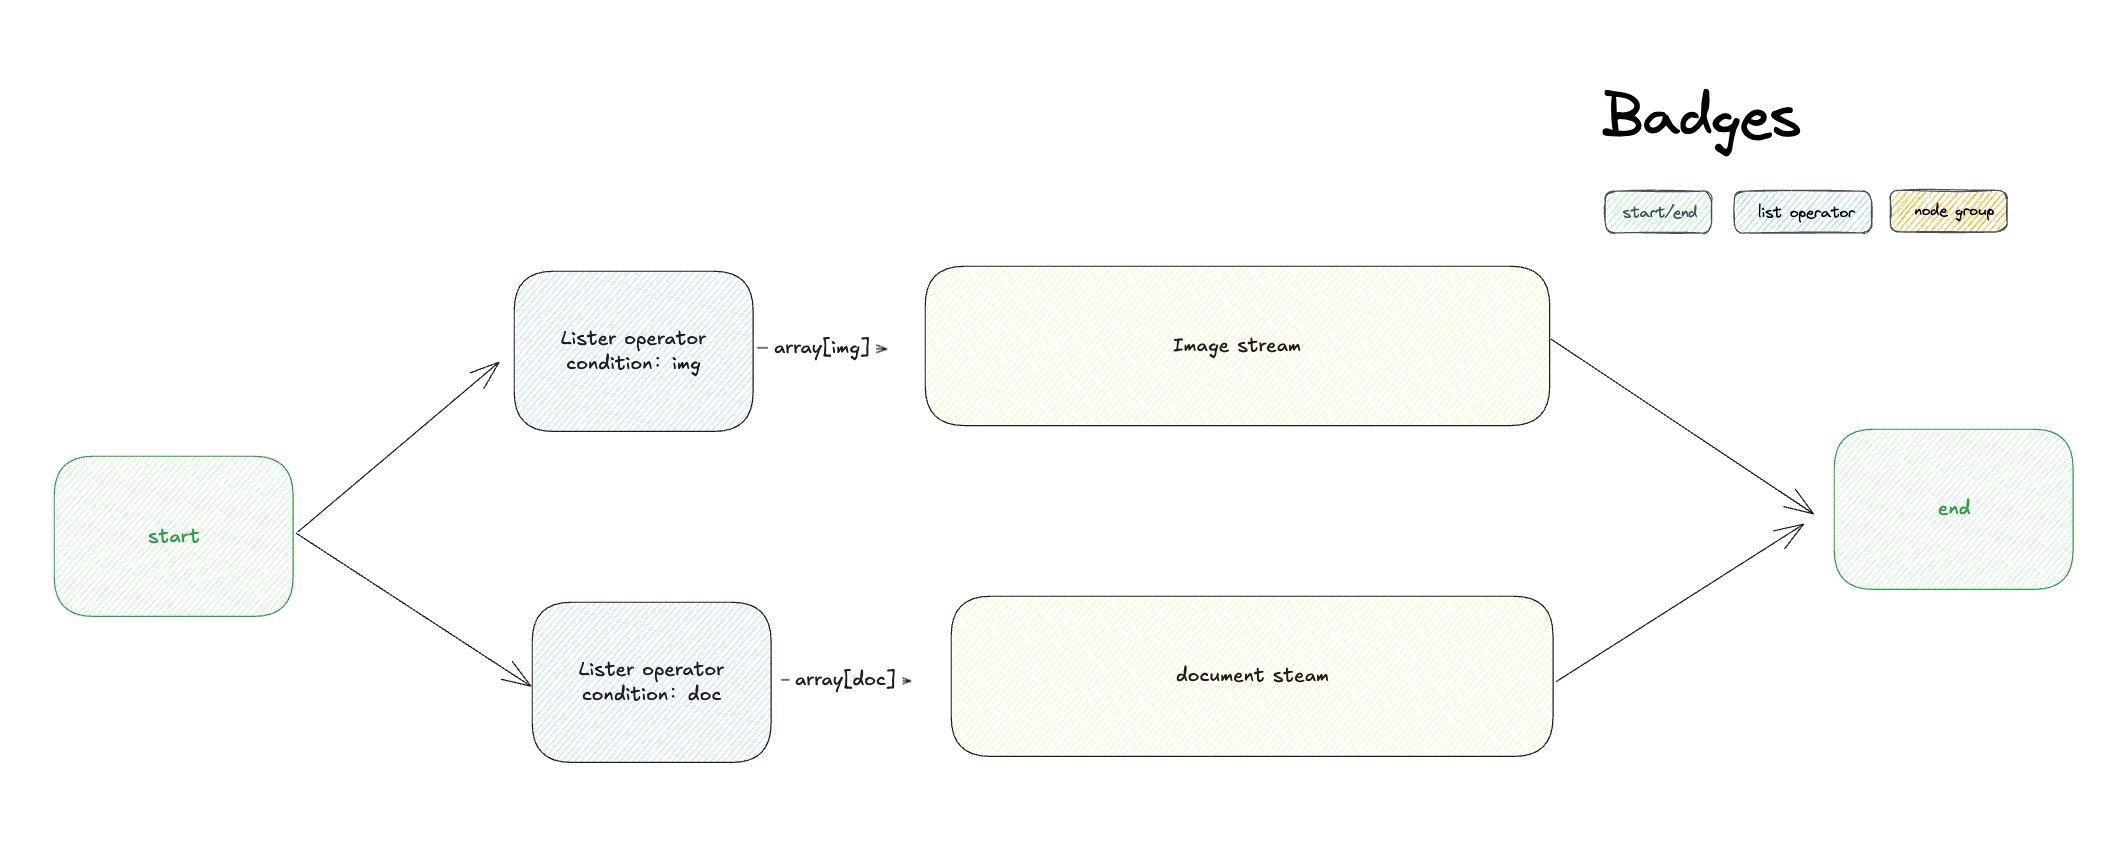
典型文件处理链路是:
Start(多文件)→ 列表操作符(只保留 PDF)→ Iteration(逐份提取与摘要)→ 合并结果
列表操作符还能输出:
result:筛选和排序后的完整数组;first_record:第一项单值;last_record:最后一项单值。
如果只需要最新一份文件,就用排序加 first_record,不必为了“显得高级”再套一层 Iteration。
Loop:不是处理很多项,而是让同一份结果继续演化
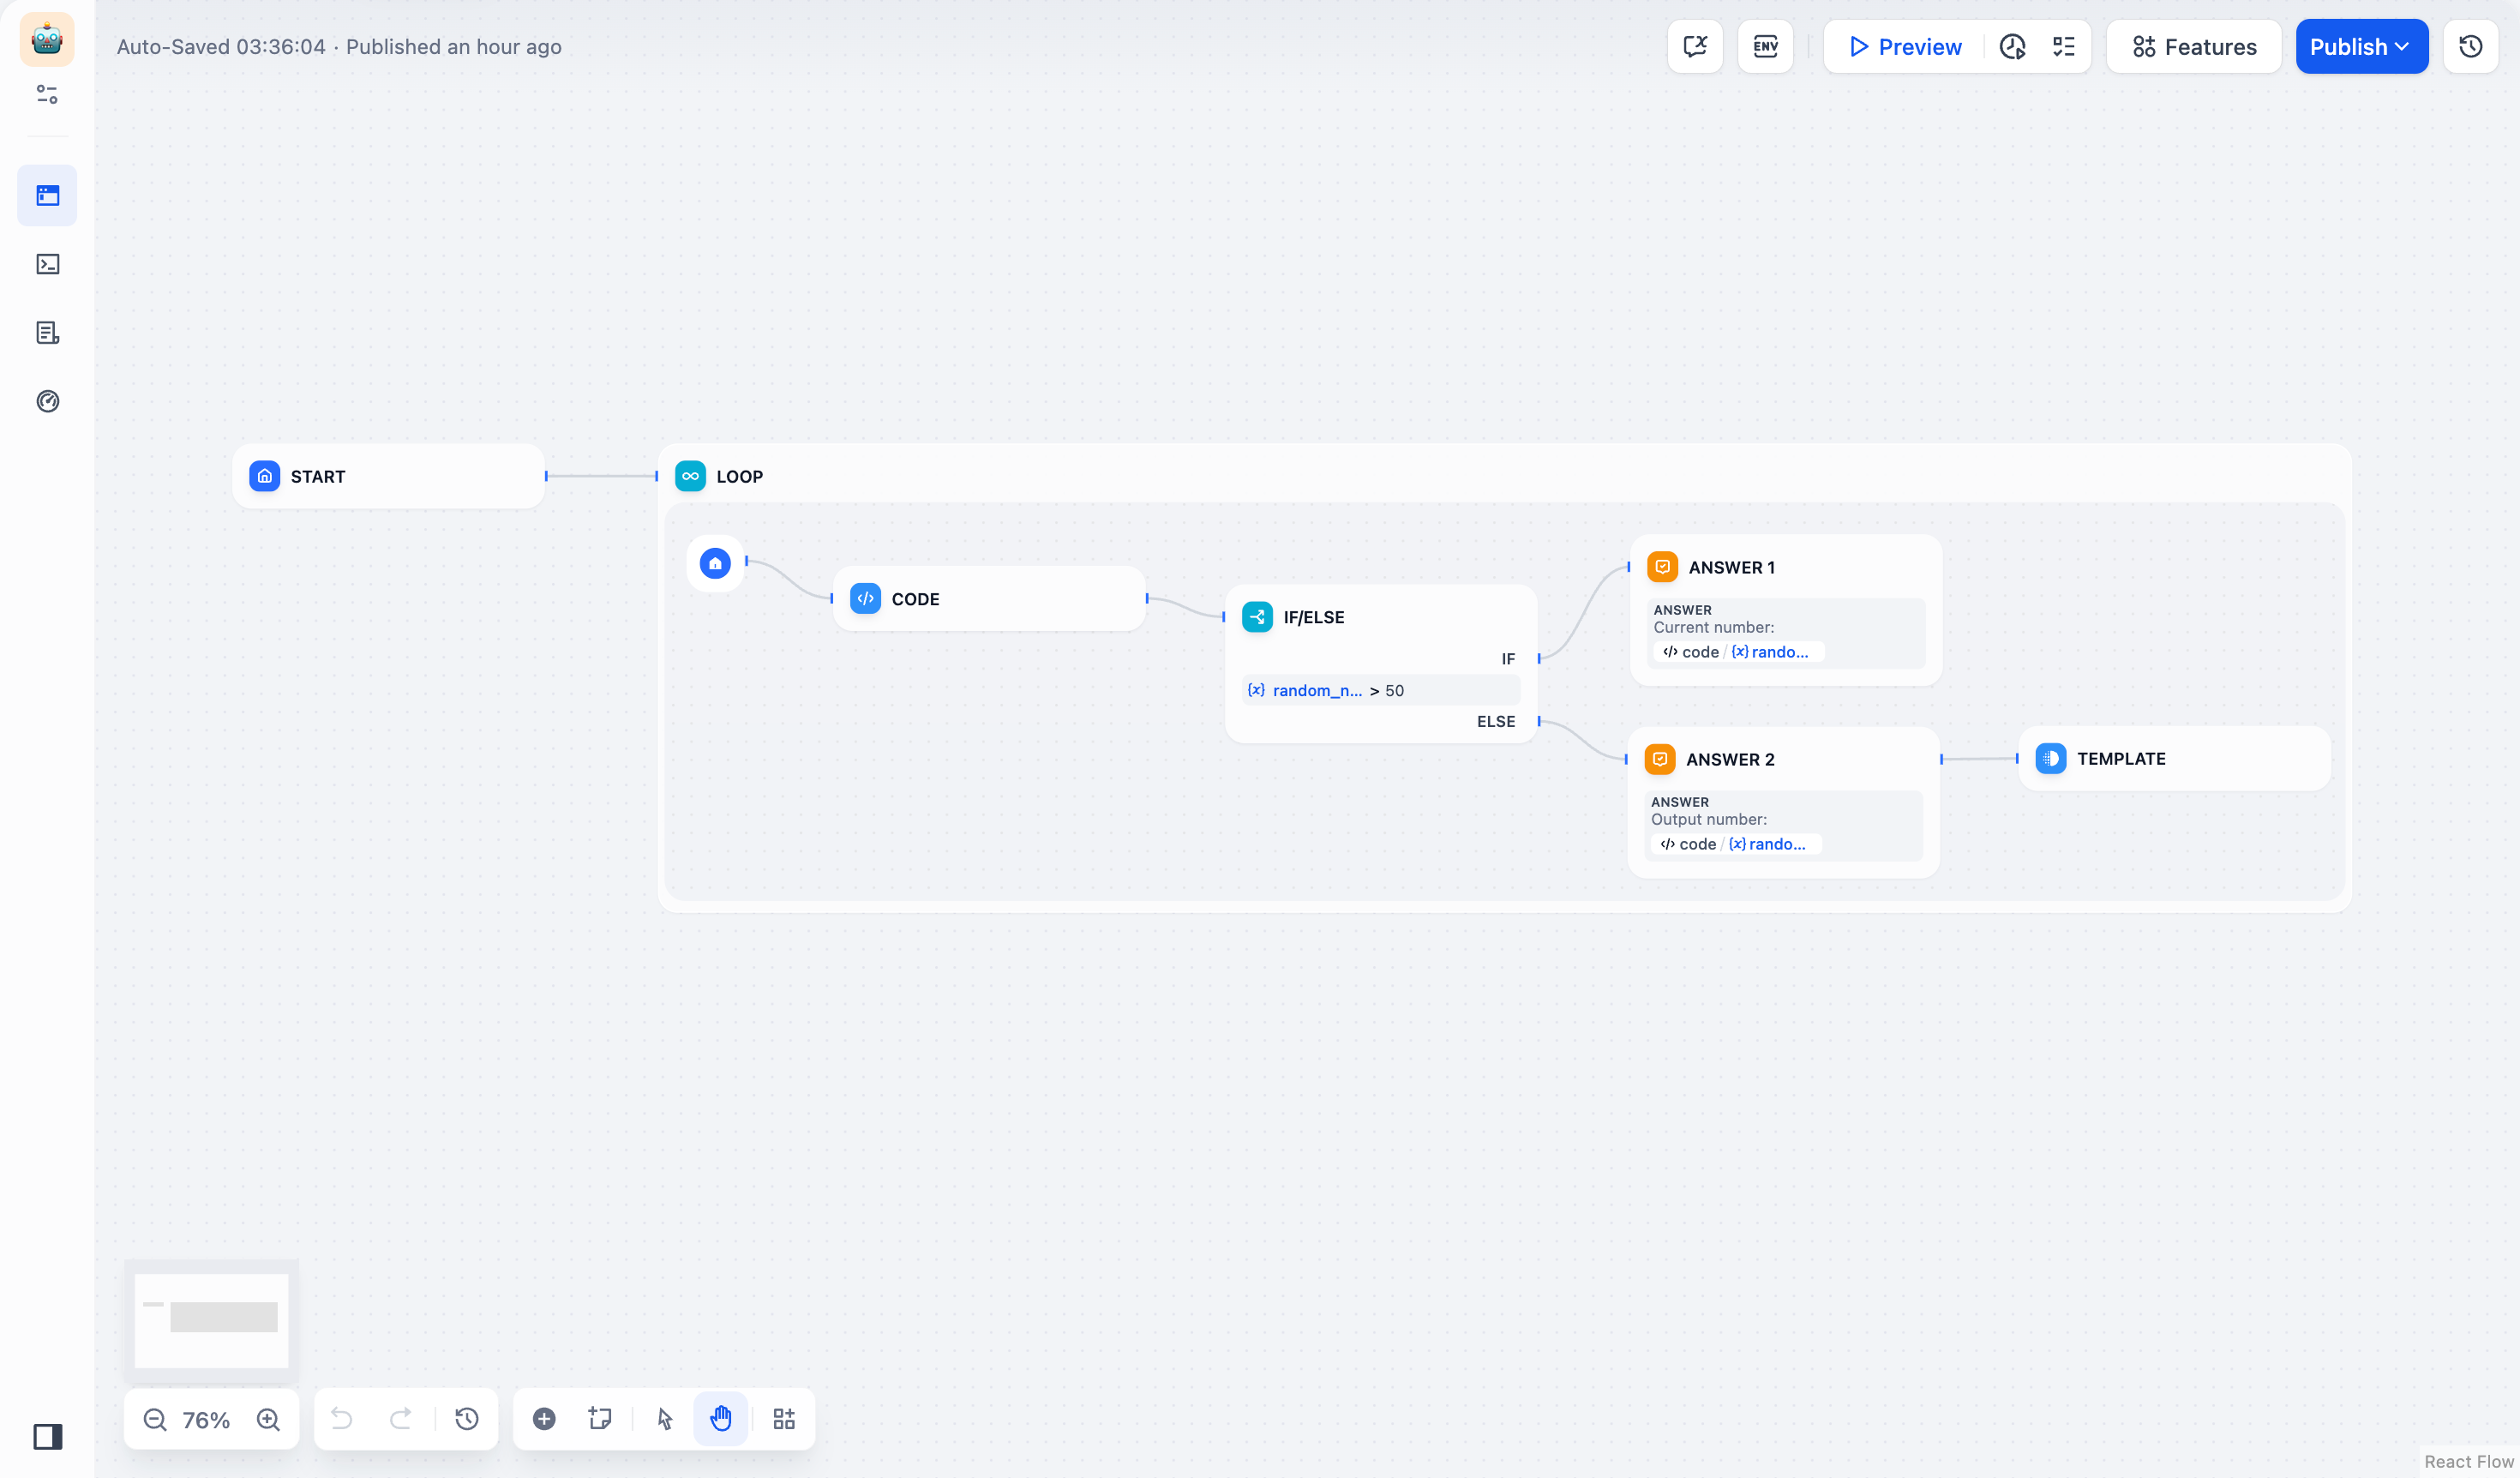
现在把问题换成“把同一段文案最多润色三轮,达到质量条件就提前停止”。这不是 Iteration,因为没有三个彼此独立的输入;第二轮必须读取第一轮生成的文案。
Loop 至少要有两类循环变量:
draft:当前版本文本;round:当前轮次计数。
每一轮执行:
检查退出条件 → LLM 基于 draft 改写 → 质量评估 → 更新 draft 与 round → 下一轮
Loop 的终止有三条路:满足循环终止条件、达到最大循环次数,或执行退出循环节点。即使已经配置质量条件,也必须保留合理的最大次数;模型评分不是稳定的数学函数,可能永远达不到目标,也可能在阈值附近来回波动。
一个稳妥的退出设计是:
quality_score >= 0.90 OR round >= 3
但要注意:让同一个模型既写稿又给自己打分,分数很可能失真。生产场景应把质量拆成可验证规则,例如是否包含必填字段、长度是否合规、引用是否存在;语义评分可以作为辅助,不能成为唯一刹车。
Loop 最危险的不是慢,而是没有刹车
循环会把单次错误放大成多次成本。以下几条应当作为发布前检查项:
- 最大循环次数是否明确且足够小;
- 终止条件引用的变量是否真的在每轮更新;
- 达到条件时能否走到退出节点;
- 外部写操作是否可能每轮重复执行;
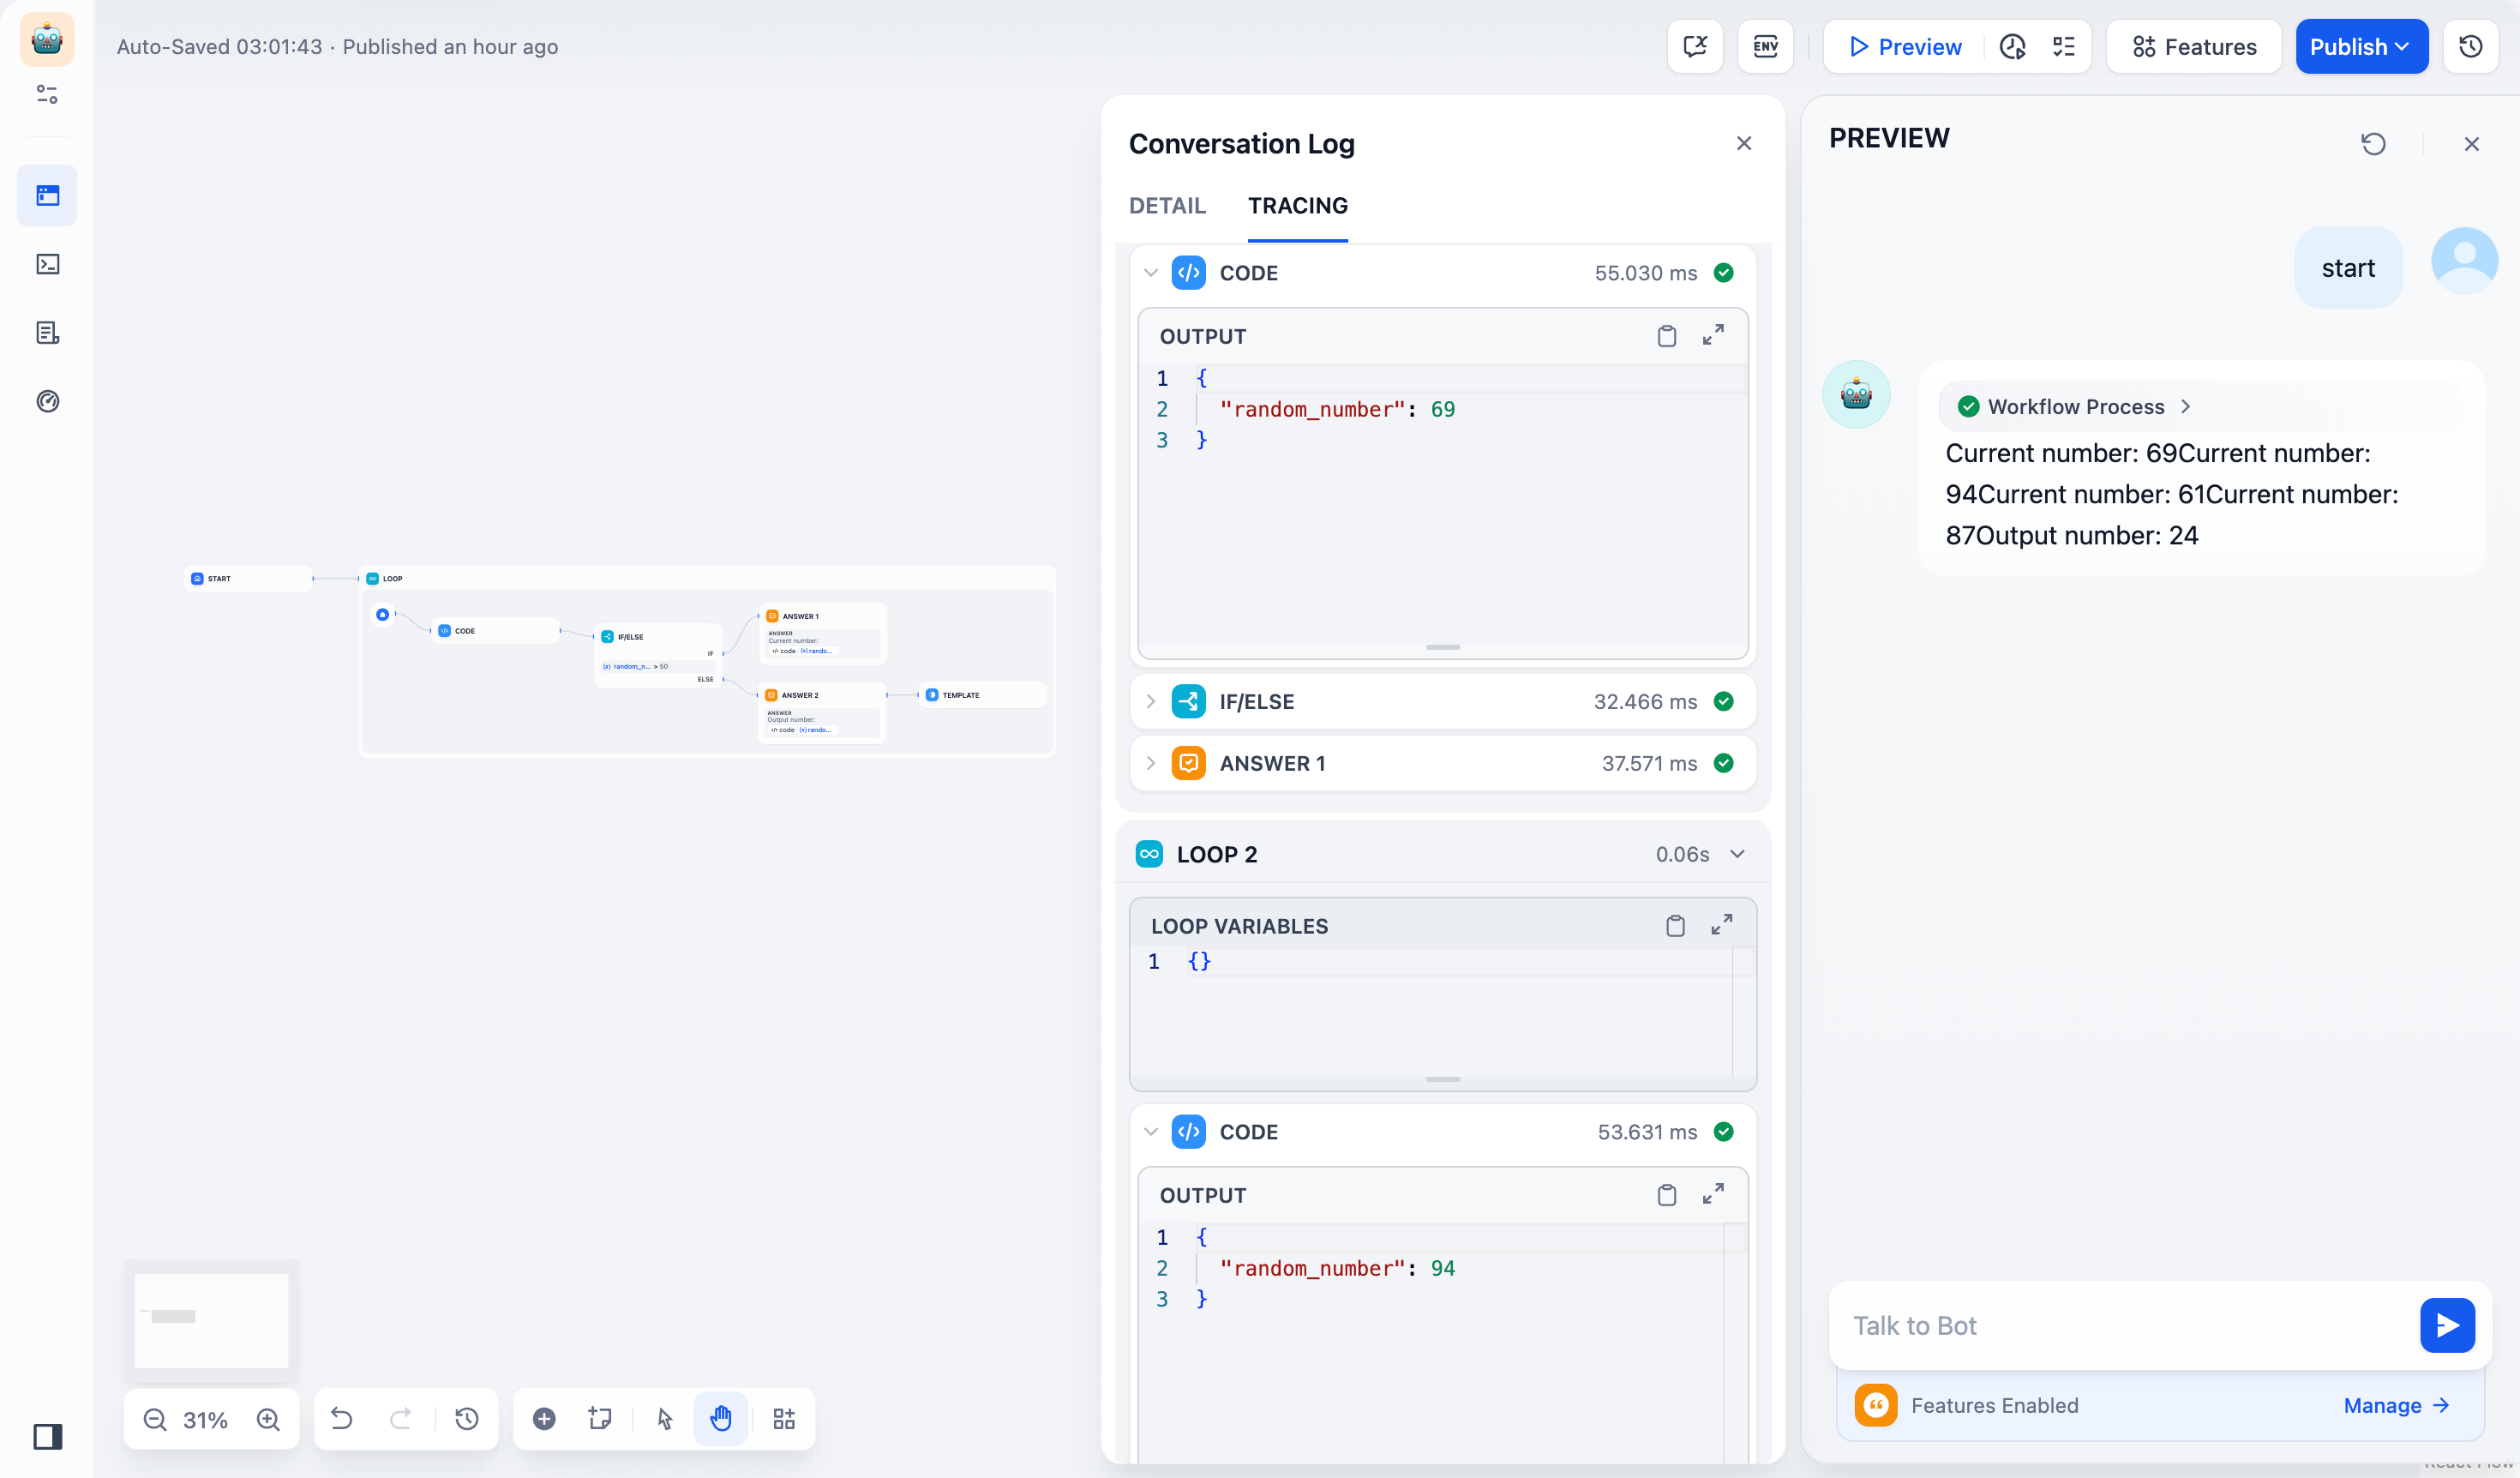
- 运行日志能否看见每轮输入、输出和耗时;
- 单轮失败时是终止、重试还是保留上一版。
如果循环内部有 HTTP 写请求,必须明确它是否幂等。比如“每轮把草稿保存为新版本”可以设计成有意保留历史;“每轮创建一条订单”则几乎一定是事故。
一套可以复用的测试清单
批量流程至少测试下面七组输入:
| 测试 | 要观察什么 |
|---|---|
| 空输入 | 在进入 Iteration 前给出可理解错误 |
| 只有 1 项 | 不因数组长度为 1 改变输出类型 |
| 有重复项 | 是否按业务要求去重并保留顺序 |
| 达到最大项数 | 成本和耗时是否可接受 |
| 中间 1 项失败 | 输出位置、null 或移除行为是否符合合同 |
| 并行执行 | 结果能否靠 ID 对齐,而不是依赖完成顺序 |
| Loop 永不达标 | 是否在最大次数处可靠停止 |
再加一条经常被忽视的验证:计算调用放大倍数。输入 8 项,每项调用 1 次模型,就是 8 次;每项内部再做 3 轮 Loop,理论上可能达到 24 次。节点数量没有明显变多,不代表成本没有成倍增长。
本次验证边界
截至 2026-09-10,本系列使用的 Dify Sandbox 工作空间已经达到应用数 5/5,无法新建独立的第七篇演示应用。我没有删除或覆盖任何既有应用,也没有把官方示例截图伪装成个人账号运行结果。
本文关于 Iteration、Loop、列表操作符、并发上限和错误策略的界面与行为,来自 Dify 官方云版文档;页面标注最后修改于 2026-06-10,中文页同时注明由 AI 自动翻译,关键定义已与英文原文交叉核对。文中的“批量内容卡片”链路、代码、Prompt 和测试表是可复现方案,但在释放应用名额前,不宣称它已经在本账号完成发布与端到端运行。
官方参考:
这一集真正应该带走什么
Iteration、Loop 和列表操作符不是三个名字相近的“批处理节点”,而是三段不同职责:列表操作符先整理数组;Iteration 让每个元素独立通过同一套步骤;Loop 让同一份状态跨轮次演进。
最重要的判断仍然只有一句:下一次执行需不需要上一次的结果? 不需要,就优先考虑 Iteration;需要,就进入 Loop,同时先把退出条件、最大次数和状态更新写清楚。
下一集,我们会把工作流的主动权再往前推进一步:让 Agent 根据目标选择工具、观察结果并决定下一步,同时讲清 ReAct、Function Calling、自定义工具和 MCP 之间到底是什么关系。